Canonical: как указать нужный адрес страницы и когда поисковик его не послушает

Что такое rel=canonical, чем канонический адрес отличается от редиректа, как прописать тег в HTML, HTTP-заголовке и Sitemap и в каких случаях Яндекс и Google его игнорируют.
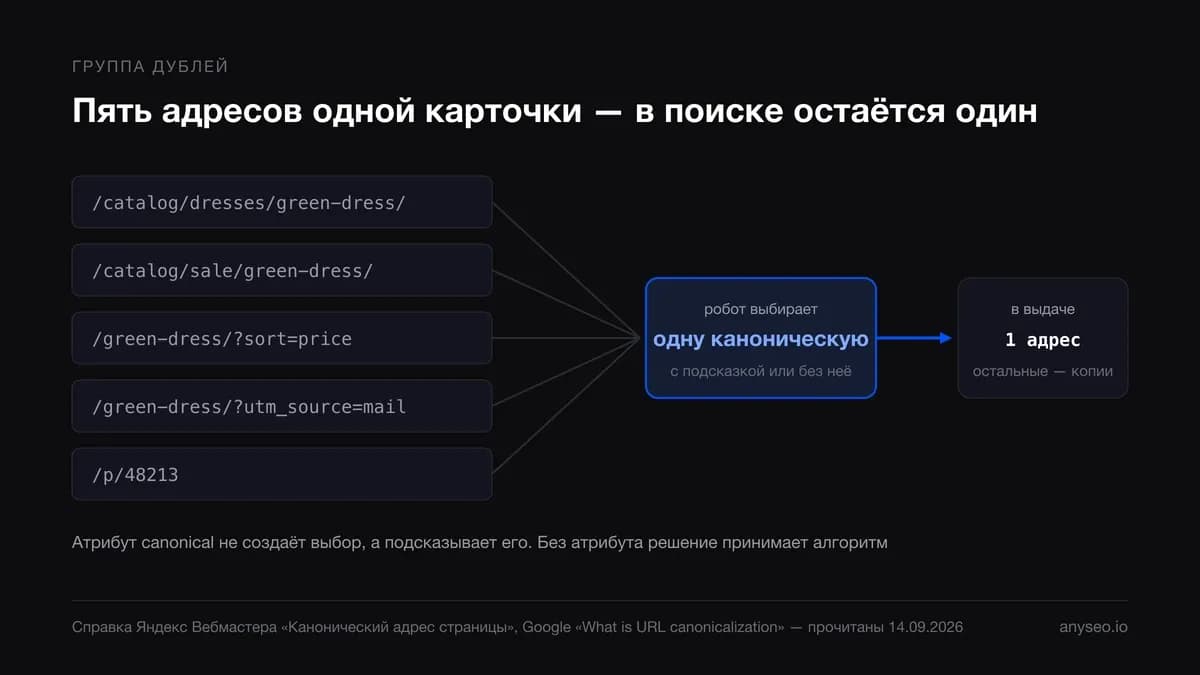
Карточка товара в интернет-магазине открывается по пяти адресам: из двух категорий, с сортировкой, с UTM-меткой из рассылки и по короткой ссылке. Для человека это одна страница. Для робота — пять документов, из которых он выберет один и покажет в выдаче. Атрибут canonical придуман, чтобы этот выбор делал владелец сайта, а не алгоритм.
«В справках обеих поисковых систем canonical назван рекомендацией, и на этом слове держится половина ошибок, которые мы видим на аудитах, — говорит Алексей Крайнов, автор блога anyseo. — Атрибут прописали, отчёт закрыли, а через месяц в выдаче стоит не тот адрес. Робот не сломался: он сравнил страницы и решил иначе. Поэтому мы проверяем не наличие разметки, а то, какую страницу поисковик в итоге считает канонической: в Вебмастере и в Search Console».
Что такое canonical и какую задачу он решает
Canonical — это указание поисковому роботу, какой из нескольких адресов с одинаковым содержанием показывать в результатах поиска. Технически это тег <link rel="canonical" href="…"> в <head> страницы либо HTTP-заголовок Link с тем же значением.
Справка Вебмастера описывает механику так: если страница доступна по нескольким адресам или на сайте есть страницы с одинаковым или схожим содержимым, робот может посчитать их дублями, объединить в группу и выбрать для показа только одну — «наиболее информативную и релевантную поисковым запросам». Такая страница и называется канонической. Атрибут позволяет подсказать роботу, какую именно.
Google в документе «What is URL canonicalization» описывает то же: система определяет основной контент каждой страницы, группирует похожие и выбирает ту, что «объективно наиболее полная и полезная для пользователей». Дальше Google использует канонические страницы как основной источник для оценки качества: их робот обходит чаще, копии — реже.
Из этого следует ключевое свойство атрибута, которое часто упускают: поисковик выбирает предпочитаемый адрес всегда, есть указание или нет. Без него выбор делает алгоритм. С ним — алгоритм с учётом вашей подсказки.
Тег, ссылка и страница: что называют каноническим
Вопрос «что такое каноническая страница» справка закрывает одним абзацем, а вот терминов вокруг механизма несколько.
Канонический тег в разговоре называют словом «каноникал», а во множественном «канониклы»: речь об одном и том же атрибуте. Важная деталь из справки Вебмастера: страница, на которой размещён атрибут с адресом другой страницы, считается неканонической. То есть разметка не «усиливает» страницу, на которой стоит, а отдаёт её в пользу другой. Единственное исключение — ссылка на саму себя, о ней ниже.
Как Яндекс и Google выбирают канонический URL
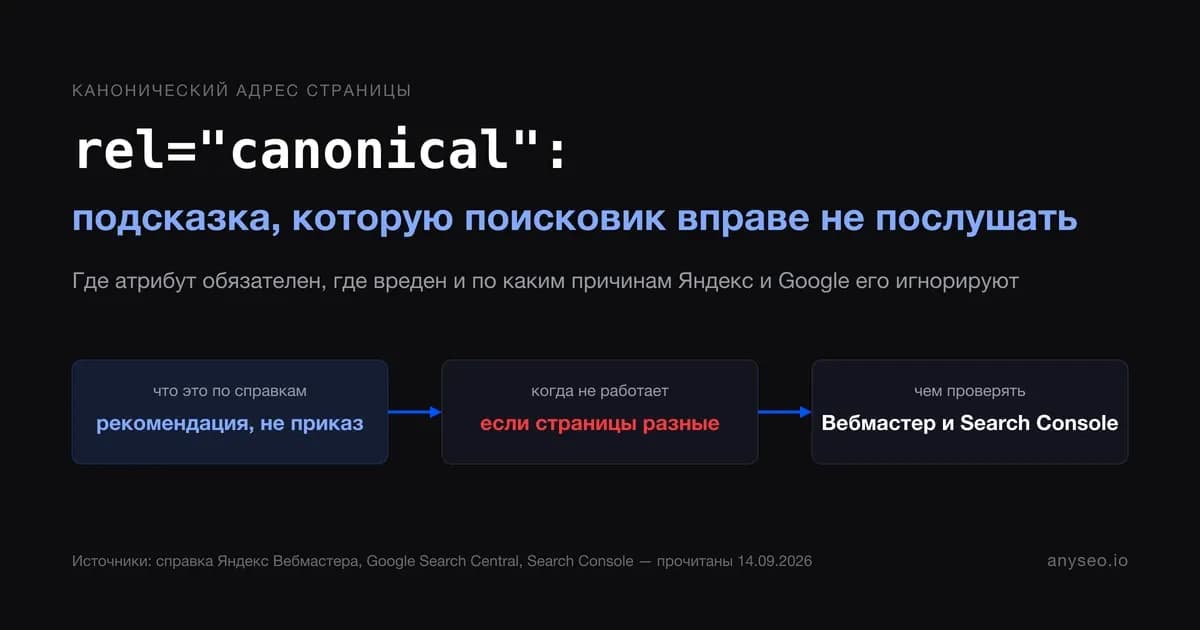
Оба поисковика прямо пишут, что прописанный адрес — не приказ. Справка Вебмастера: робот «воспринимает указание на канонический адрес как рекомендацию и может проигнорировать его в нескольких случаях». Google: «indicating a canonical preference is a hint, not a rule» — подсказка, а не правило.
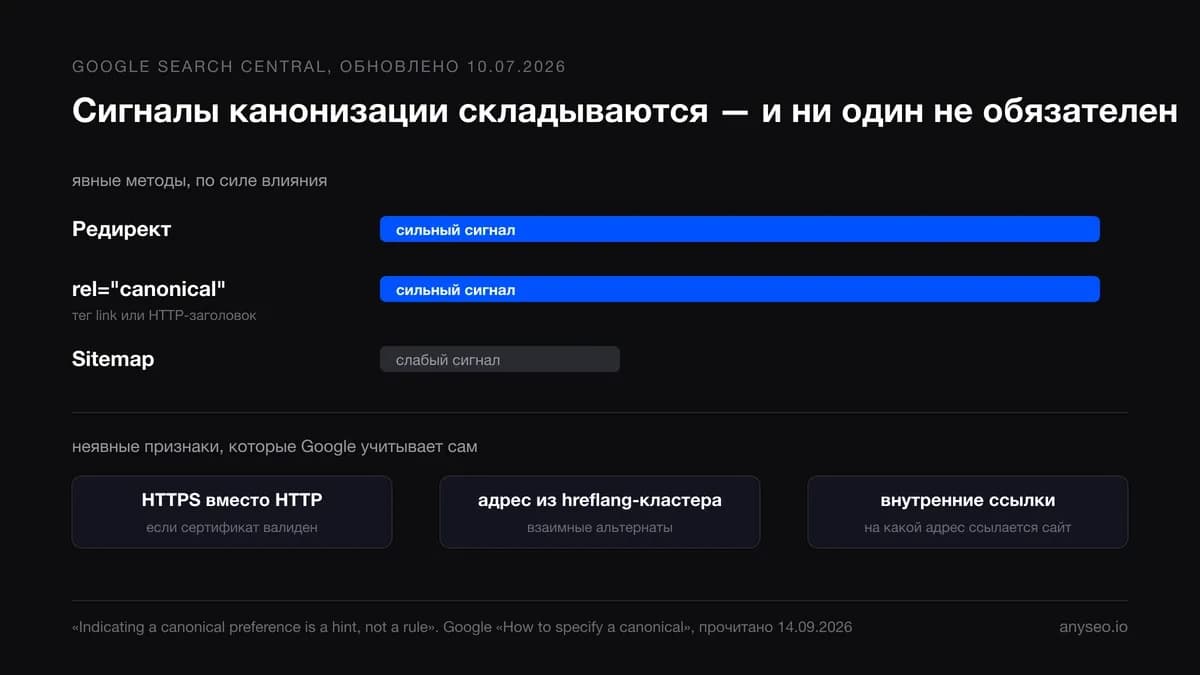
Что ещё учитывается, Google перечисляет в документе «How to specify a canonical» (обновлён 10 июля 2026). Методы расставлены по силе влияния:
- Редирект: сильный сигнал в пользу адреса назначения.
- Атрибут rel canonical: сильный сигнал в пользу указанного адреса.
- Присутствие в Sitemap: слабый сигнал.
Дальше в том же документе: сигналы складываются, и когда два метода указывают на один адрес, шанс увидеть его в выдаче выше. Отдельно названы неявные признаки: предпочтение HTTPS перед HTTP и адресов из hreflang-кластера. И ещё один, который редко вспоминают, — внутренняя перелинковка. Google просит ссылаться внутри сайта на канонический URL, а не на копию — последовательные ссылки помогают понять ваше предпочтение.
У Яндекса открытого рейтинга сигналов нет, но есть принцип, который перевешивает всё остальное: контент. Робот игнорирует указание, если содержимое канонической страницы значительно отличается от копии. В таком случае в поиске может участвовать именно копия. Google формулирует то же в справке отчёта об индексировании: если заявленный канонический URL не похож на текущую страницу, Google «никогда не выберет этот URL в качестве канонического».
Спор «ставить или не ставить» второстепенен — canonical помогает только там, где страницы действительно повторяют друг друга. Там, где тексты разные, его не послушают ни в одной из систем.
Когда canonical нужен
Обе справки соглашаются, что указать канонический URL не обязательно: Google прямо пишет, что «сайт, скорее всего, будет в порядке и без этого». Но есть три группы ситуаций, где без подсказки робот регулярно выбирает не тот адрес.
Дубли из-за параметров, фильтров и сортировок
Классический источник копий — GET-параметры, которые не меняют страницу: метки рекламы, идентификаторы сессий, порядок сортировки в каталоге.
У двух поисковиков разные инструменты. Google советует прописать canonical на чистый адрес — и внутри сайта ссылаться только на него. Справка Вебмастера отдельно оговаривает: чтобы исключить из поиска копию с GET-параметрами или метками (UTM, from и подобными), нужно добавить директиву Clean-param в robots.txt. В описании самой директивы объяснено, почему: Clean-param «позволяет передавать основному URL или сайту некоторые накопленные показатели», а обычный Disallow — нет.
Рабочая связка для сайта под обе системы — атрибут на чистый адрес плюс Clean-param. Так у нас устроен и этот блог: адрес статьи с ?utm_source=… отдаёт canonical на URL без параметра (проверено curl 14 сентября 2026).
Версии http и https, www и мобильная версия
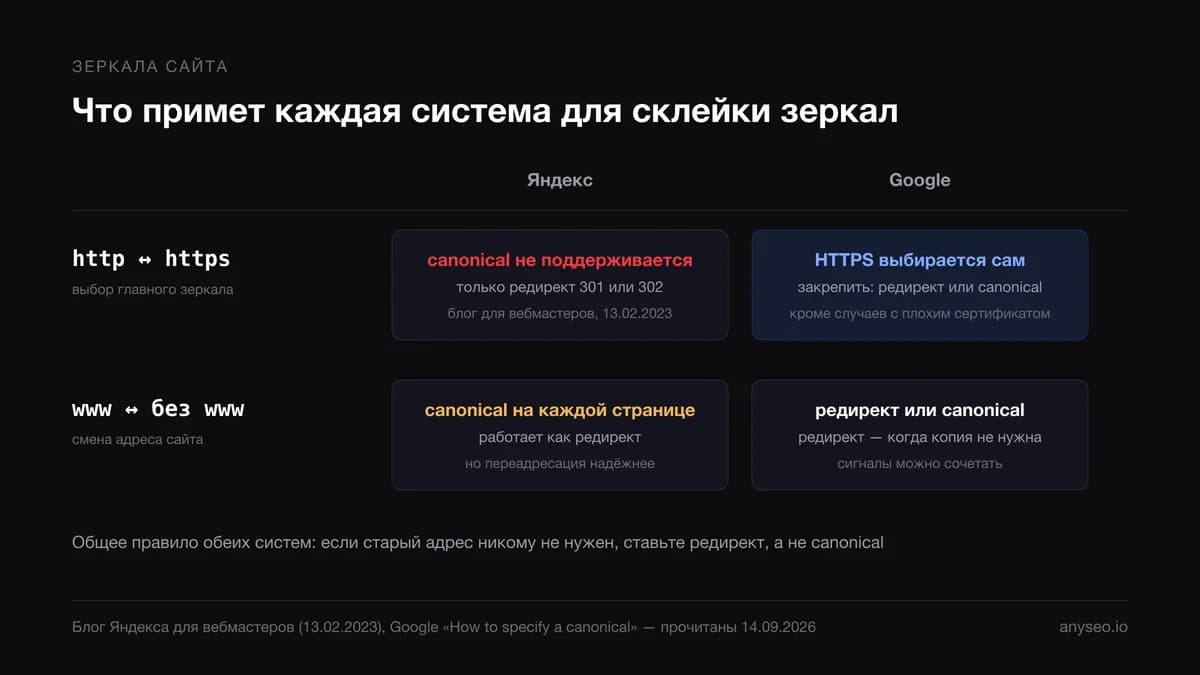
Вокруг зеркал сайта самое старое и самое устойчивое заблуждение: «склеить http и https можно через canonical». В Яндексе — нельзя. Блог для вебмастеров 13 февраля 2023 объявил: для выбора главного зеркала между http://site.ru и https://site.ru атрибут больше не поддерживается, вместо него нужен редирект 301 или 302. Если переадресации нет, поисковик выберет зеркало сам, «предпочтение обычно отдается адресам с https».
Для пары www / без www указание по-прежнему принимается: робот воспримет его как редирект на новый главный адрес сайта и объединит две версии. Условие — атрибут должен стоять на каждой странице старого зеркала и вести на аналогичную страницу нового; иначе робот может счесть это различием в структуре, и переезд не состоится. И даже здесь блог советует переадресацию как более надёжный метод.
Google решает за вас: HTTPS-версия выбирается канонической по умолчанию. Исключения — невалидный сертификат, небезопасные зависимости на странице, редирект с HTTPS на HTTP и canonical, ведущий с HTTPS на HTTP. Отдельно предупреждают: плохой сертификат заставляет Google очень сильно предпочитать HTTP, и HSTS это не перебивает.
Мобильная версия вида m.site.ru: случай, где Google просит использовать canonical в паре с rel="alternate": на десктопной странице стоит alternate на мобильную, на мобильной — canonical на десктопную. В справке Вебмастера такой конструкции нет: отдельный хост остаётся территорией, куда указание не дотягивается.
Один текст в нескольких разделах и на чужих площадках
Копии возникают и без параметров: товар лежит в двух категориях, у статьи есть версия для печати, страница открывается и по короткому, и по полному адресу. Справка «Дублирование страниц» называет это «естественными» причинами и советует указать предпочитаемый адрес.
Отдельная история — тот же материал на другом домене: синдикация, перепечатка, переезд на новый сайт без возможности настроить переадресацию. Google этот сценарий поддерживает с декабря 2009 года: в посте «Handling legitimate cross-domain content duplication» сказано, что атрибут можно использовать между доменами, страницы должны быть похожи, а ссылаться всеми страницами на главную другого сайта нельзя — нужна карта «старый адрес → новый».
В справке Вебмастера кросс-доменное указание стоит в списке причин игнорирования: URL в другом домене или поддомене не учитывается. Если материал уходит на другой домен и вам важен Яндекс — нужна переадресация или разный контент.
Когда canonical не подходит и что ставить вместо него
Атрибут не универсален. Есть три ситуации, где использовать канонические ссылки либо вредно, либо бесполезно.
Страницы пагинации
Самая частая ошибка каталогов: на страницах 2, 3, 4 списка стоит указание на первую. Логика понятна — «это же один список». Но наполнение страниц разное, и поисковики читают это буквально.
Google в документе о постраничной навигации (обновлён 10 декабря 2025) пишет прямо: «Don't use the first page of a paginated sequence as the canonical page. Instead, give each page its own canonical URL». Страницы последовательности считаются отдельными документами.
Отдельной справки о пагинации у Вебмастера нет, но есть пост 2019 года о таких страницах в поиске, и в нём эта ошибка разобрана на примере: литературное произведение разбито на страницы, канонической указана первая — «в результате сайт не находится по запросу-цитате, соответствующей тексту за пределами первой страницы». Правило одно: у каждой страницы списка — свой адрес и ссылка на саму себя, а параметры сортировки и фильтров сводятся к базовому виду.
Разные языки и разное содержание
Локализованные версии — не копии. Google считает языковые версии дублями только если текст на одном языке, а переведены лишь шапка и подвал. Для языков и регионов есть hreflang; canonical между ними Google просит прописывать в пределах одного языка. Попытка склеить русскую и английскую страницу приведёт к тому, что одна из них выпадет из выдачи.
То же со страницами с разным наполнением: «похожие по смыслу» — не «одинаковые». Робот сравнит страницы и проигнорирует указание, а вы получите копию в поиске и непонятный отчёт.
Canonical или 301 редирект
Два инструмента решают соседние задачи, и выбор между ними сводится к одному вопросу: должен ли старый адрес продолжать открываться.
Google пишет об этом одной фразой: переадресацию используйте, «когда дубль выводится из употребления». Справка о дублях перечисляет редирект первым способом, canonical — вторым. Подробно про коды и настройку переадресации — в статье про 301 редирект.
Как настроить canonical: тег link, HTTP-заголовок и Sitemap
Тег canonical в HTML. Элемент link ставится в <head> каждой копии и ведёт на предпочитаемый адрес:
<link rel="canonical" href="https://example.com/catalog/green-dress/">Google принимает его только внутри <head>, поэтому разметка секции должна быть валидной: незакрытый тег выше по коду может «выбросить» canonical в <body>, где он не читается. При клиентском рендеринге Google просит держать его в исходном HTML и не менять скриптами.
HTTP-заголовок `Link`. Нужен там, где HTML нет: если требуется настроить canonical на PDF, документ или другой файл. Пример из справки Вебмастера — один PDF по двум путям, сервер отдаёт для копии:
Link: <https://example.com/offer/file.pdf>; rel="canonical"Google просит выбрать один из двух способов и не смешивать: одновременный тег и заголовок «более подвержены ошибкам» — легко указать в них разные адреса.
Sitemap. Указывать канонический URL можно и в карте сайта: Google рассматривает адреса из неё как предложенные, но это слабый сигнал — система сама решит, какие страницы считать копиями. Для крупных сайтов это удобный способ обозначить предпочтения, но не замена атрибуту.
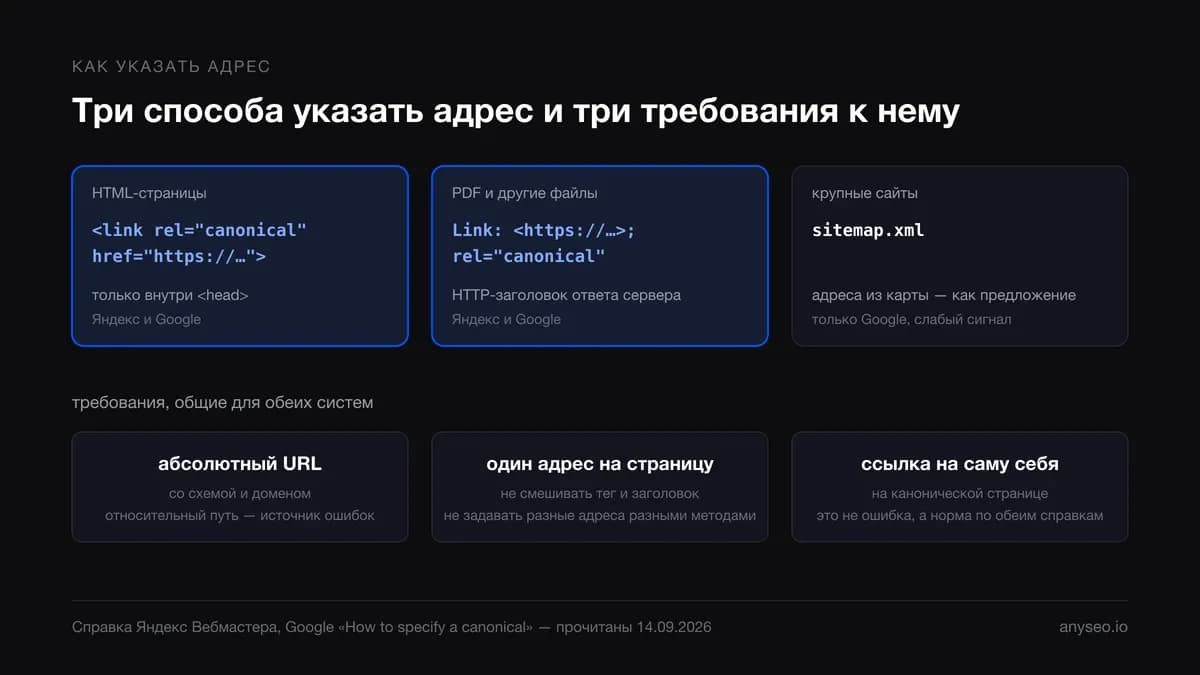
Три требования при настройке canonical, общие для обеих систем:
- Абсолютные адреса со схемой и доменом. Справка Вебмастера: «задавайте абсолютный путь». Google относительные пути читает, но не рекомендует — при случайно открытом для обхода тестовом домене они указывают не туда.
- Один адрес на страницу. Несколько указаний — в списке причин игнорирования в справке; Google просит не задавать разные адреса разными методами (один в Sitemap, другой в разметке).
- Ссылка на саму себя на странице-оригинале. Справка Вебмастера на вопрос «атрибут указывает на страницу, на которой размещён, это ошибка?» отвечает: нет, робот посчитает её канонической. Google рекомендует то же.
Чтобы настроить канонические ссылки в CMS, Google советует искать настройку по запросу вида «wordpress set the canonical element», а не править шаблон вручную. Чтобы настроить канонические ссылки на сотнях страниц, опишите правило в шаблоне один раз.
Ошибки, из-за которых canonical игнорируется
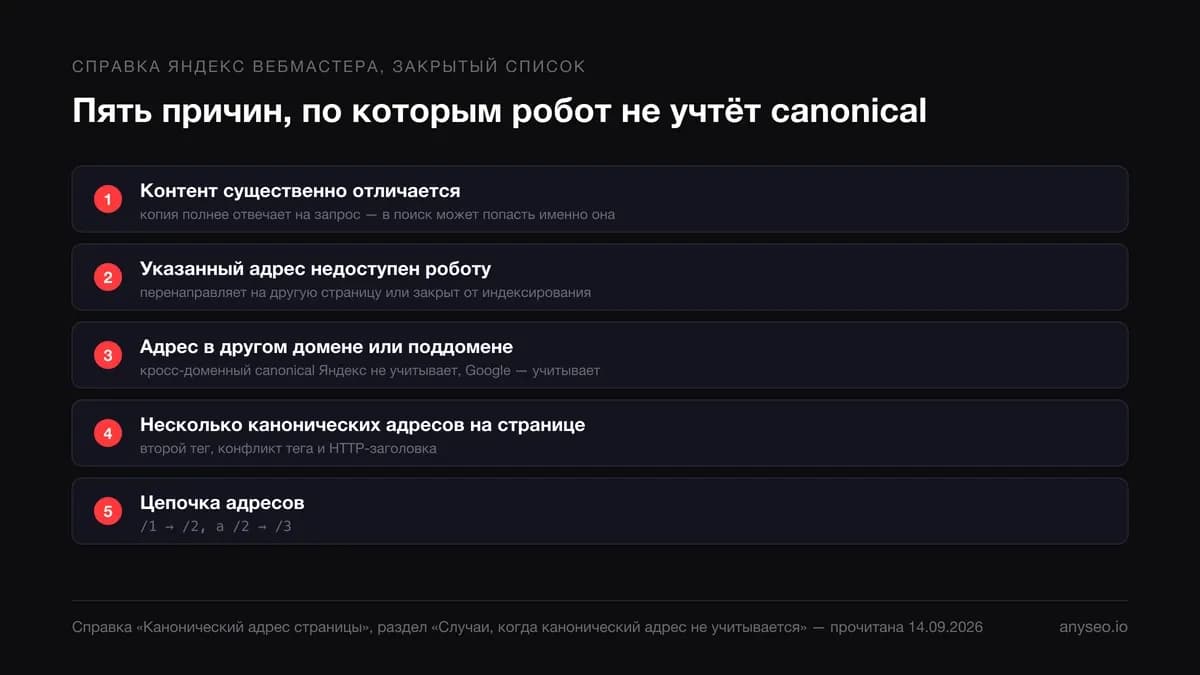
В справке Вебмастера список причин закрытый. У Google он размазан по нескольким документам. Сведём в одну таблицу.
Последняя строка связана с частым советом «закрыть копии в robots.txt». Google прямо пишет: не использовать robots.txt для канонизации, закрытые адреса могут попасть в индекс без содержимого. И не использовать noindex, чтобы помешать выбору оригинала внутри одного сайта, — он полностью уберёт страницу из поиска, тогда как canonical помогает объединить сигналы. В справке о дублях Disallow перечислен как рабочий способ, но для параметров та же справка рекомендует Clean-param — именно потому, что запрет обрывает передачу накопленных показателей.
Ошибка первого типа — «указание ведёт на страницу с другим текстом» — случилась и у нас. После публикации двух статей этого блога 8 и 9 сентября 2026 первые часы страницы отдавали <title> и canonical лендинга, https://anyseo.io, при правильном теле статьи: кэш Next.js собрал шапку раньше, чем в CMS появился материал. Через сутки адрес в разметке стал вести на саму статью. Робот в это окно увидел бы статью на две с половиной тысячи слов, которая просит считать её копией титульной страницы. По обеим справкам такое указание проигнорировали бы, но полагаться на это нельзя. Дефект заведён в бэклог сайта.
Как проверить, какой адрес выбрал поисковик
1. Посмотреть, что отдаёт сервер. Первое, что проверяем при настройке canonical, — сырой ответ, а не вкладку браузера с расширениями:
curl -s https://example.com/page/ | grep -i 'rel="canonical"'
curl -sI https://example.com/file.pdf | grep -i '^link'
Первая команда покажет тег в HTML, вторая — заголовок Link. Проверять надо и копию, и оригинал: на копии указание ведёт на оригинал, на оригинале — на самого себя. Заодно виден относительный путь или второй тег.
2. Вебмастер. Раздел Индексирование → Страницы в поиске, блок «Исключённые страницы». Справка называет статус, который надо искать: «Неканоническая» (NOT_CANONICAL в выгрузке): страница проиндексирована по адресу из атрибута rel canonical в её исходном коде. Соседние статусы: «Дубль» (DUPLICATE, робот склеил страницы сам), «Исключена по Clean-param», «Неглавный адрес сайта». Обратная ситуация, когда атрибут есть, а страница в поиске с пометкой «Неканоническая», означает, что робот счёл страницы существенно разными и оставил обе.
3. Search Console. Инструмент проверки URL, блок «Индексирование страниц» и два поля: «Канонический URL, указанный пользователем» и «Канонический URL, выбранный Google». Если совпадают, подсказка принята. Если нет, Google выбрал иначе, и в отчёте об индексировании страница будет числиться как «Страница является копией. Канонические версии страницы, выбранные Google и пользователем, не совпадают». Справка предупреждает о двух ограничениях: значение может отставать от индекса на несколько часов, а проверка опубликованной страницы («live test») выбор Google не предсказывает — смотреть надо проиндексированную версию.
Ни одна из справок не называет срок, за который изменённая разметка вступает в силу. Справка Вебмастера пишет, что робот узнаёт об изменениях при обходе, и предлагает отправить страницу на переобход; Google говорит о том же.
Частые вопросы
Нужно ли использовать canonical на странице, у которой нет копий? Обе системы отвечают: каноническая ссылка на саму себя допустима и полезна. Google в списке лучших практик просит её добавлять; справка Вебмастера подтверждает, что робот посчитает её канонической. Она защищает от случайных копий — с параметрами, с завершающим слешем, в другом регистре.
Передаёт ли canonical ссылочный вес? У Google в текущей документации сказано, что атрибут помогает «консолидировать сигналы» копий, включая ссылки на них, в один адрес; в посте 2009 года формулировка жёстче — «будут переданы дополнительные свойства URL, например PageRank». В справке Вебмастера про ссылочные сигналы нет ни слова; единственная похожая фраза — про Clean-param, который «позволяет передавать основному URL некоторые накопленные показатели». Утверждать «передаёт 100 %» нельзя ни для одной из систем.
Можно ли указать canonical на другой домен? В Google — да, с 2009 года, если страницы похожи и есть постраничная карта соответствия. В Яндексе — нет: адрес на другом домене в списке причин игнорирования.
Canonical и noindex на одной странице: конфликт? Google не запрещает сочетание, но не рекомендует использовать noindex для управления выбором оригинала: он уберёт страницу целиком, а сигналы не объединит. Если задача склеить копии, canonical должен стоять один, без noindex. Если задача убрать страницу из поиска совсем, нужен только noindex.
Источники
- Яндекс Вебмастер: канонический адрес страницы
- Яндекс Вебмастер: дублирование страниц
- Яндекс Вебмастер: директива Clean-param
- Яндекс Вебмастер: статусы страниц в поиске
- Блог Яндекса для вебмастеров: отключение поддержки rel=canonical при переезде на https (13.02.2023)
- Блог Яндекса для вебмастеров: неканонические страницы в Поиске (04.07.2019)
- Google Search Central: что такое канонизация URL
- Google Search Central: как указать канонический URL
- Google Search Central: пагинация и постепенная загрузка
- Google Search Central: мобильные сайты на отдельных URL
- Google Search Central Blog: кросс-доменный canonical (15.12.2009)
- Google Search Central Blog: указание канонической страницы (12.02.2009)
- Справка Search Console: инструмент проверки URL
- Справка Search Console: отчёт об индексировании страниц
Об авторе
Автор anyseo — о SEO-стратегии, контенте и измеримом росте
Алексей Крайнов пишет для anyseo о практической стороне поискового продвижения: как исследовать реальный спрос, превращать его в понятную структуру сайта и оценивать вклад контента в задачи бизнеса. В материалах делает акцент на проверяемых источниках, ясных приоритетах и решениях, которые можно повторить на реальном проекте.
Все статьи автора