GEO-оптимизация: как попасть в ответы нейросетей и как проверить, что вы туда попали

Что такое GEO-оптимизация и что из неё подтверждено документацией Google, Яндекса, OpenAI и Perplexity. Какие приёмы дали измеренный прирост видимости в исследовании GEO и как проверить свою цитируемость без бюджета.
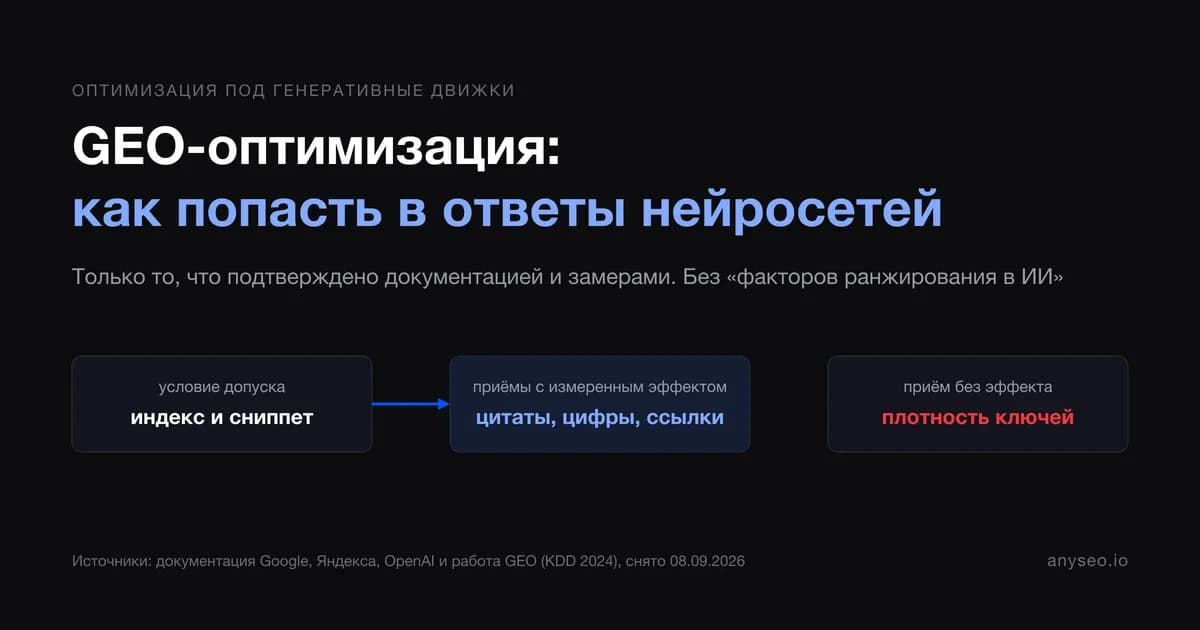
Запрос «GEO-оптимизация» за год превратился в отдельную услугу с прайсами, чек-листами и обещаниями «попасть в ответы нейросетей за месяц». При этом Google в собственной документации пишет, что отдельных требований под ИИ-функции не существует, а Яндекс — что источником ответов Нейро становятся сайты, которые и так высоко ранжируются в поиске.
Мы собрали этот материал по одному правилу: в тексте остаётся только то, что подтверждается первоисточником — документацией поисковой системы, документацией вендора ИИ-сервиса или научной работой с опубликованной методикой. Всё, что встречается у конкурентов, но не подтверждается ничем, кроме их уверенности, вынесено в отдельный раздел про границы метода.
«В GEO ровно одна честная новость: единственный набор приёмов с измеренным эффектом — это цитаты, цифры и ссылки на источники. Всё остальное, что продают под этим словом, это обычное техническое SEO, которое вы должны были сделать раньше», — Алексей Крайнов, anyseo.
Дальше — механика: кто ходит на ваш сайт, что об отборе источников говорят сами поисковые системы, какие правки контента дали прирост в замерах и как проверить результат так, чтобы проверку можно было повторить через месяц.
Что такое GEO-оптимизация простыми словами
Что такое GEO, проще всего объяснить расшифровкой: generative engine optimization — это оптимизация под генеративные движки. Термин GEO ввела научная группа в работе, принятой на конференцию KDD в 2024 году: генеративным движком там называется любая система, которая отвечает на вопрос не списком ссылок, а связным текстом, собранным из нескольких источников.
Задача GEO формулируется просто: сделать так, чтобы ваш материал попал в число источников, из которых модель собирает ответ, и был в этом ответе процитирован. Не «занять первую строчку», а «стать тем, на кого сослались». Почему GEO выделили в отдельную задачу: в списке ссылок сайт борется за клик, а в сгенерированном ответе — за то, чтобы его вообще упомянули. GEO помогает попасть внутрь ответа, а не под него.
Практически это касается четырёх сценариев, которые уже работают в рунете: AI Overviews и AI Mode в Google, Нейро и быстрые ответы в поиске Яндекса, ответы ChatGPT с ссылками на веб-страницы и ответы Perplexity. Механика у них разная, но общая часть одна: сначала система находит страницы, потом отбирает из них фрагменты, и только потом пишет ответ.
Чем GEO отличается от SEO и в чём с ним совпадает
GEO отличается от привычного SEO ровно одним: формой результата. В классическом поиске ваш результат — позиция в списке и клик по ней. В генеративном ответе результат — цитата и ссылка в блоке источников, а клик может не произойти вовсе: часть пользователей получает ответ и закрывает вкладку.
Совпадает всё остальное, и обычная поисковая оптимизация остаётся здесь фундаментом. Чтобы страница попала в ИИ-ответ Google, она должна быть проиндексирована и иметь право показываться со сниппетом — это дословное требование из документации Google Search Central. Чтобы страница чаще становилась источником Нейро, она должна высоко ранжироваться в поиске Яндекса — это дословная рекомендация из блога Яндекса для вебмастеров.
Отсюда практический вывод, который редко нравится заказчику: если страница не в индексе или не ранжируется, никакая генеративная оптимизация к ней неприменима. Сначала обычное SEO, потом GEO.
GEO, AEO и LLMO: три названия одного явления
В статьях встречаются три сокращения. GEO — generative engine optimization, из научной работы; в рунете ту же услугу чаще продают под вывеской «GEO-продвижение». AEO расшифровывается как answer engine optimization, оптимизация под ответы. LLMO — работа с большими языковыми моделями.
Что такое GEO, мы разобрали выше; важно другое: ни одна поисковая система ни один из этих терминов официально не использует. Это отраслевой жаргон, возникший вокруг одной задачи, и выбирать между ними по смыслу бессмысленно: важно, что именно человек делает, а не как он это называет. Дальше в тексте мы говорим «GEO», потому что за этим термином стоит хотя бы одна опубликованная методика с числами.
Как нейросеть решает, кого процитировать
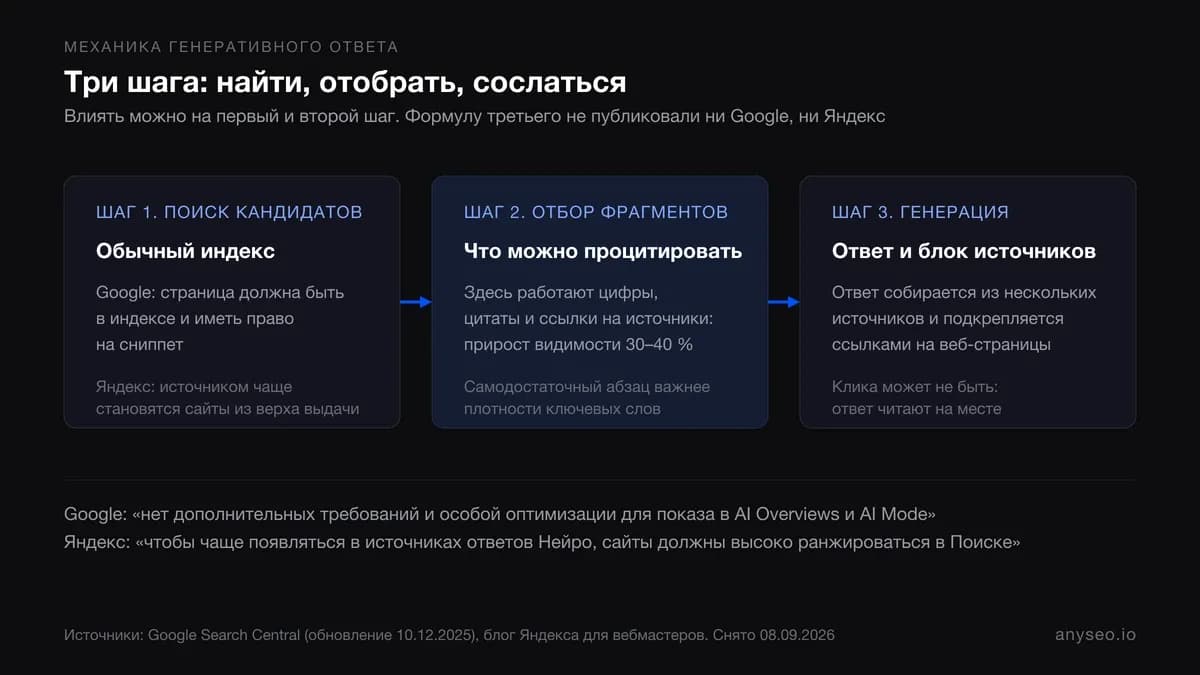
Общий подход у всех перечисленных сервисов состоит из трёх шагов. Сначала система ищет кандидатов — обычным поисковым индексом или собственным обходом. Потом отбирает из найденного фрагменты, релевантные вопросу. Потом генерирует ответ и расставляет ссылки на использованные страницы.
Ни Google, ни Яндекс не публиковали алгоритмы отбора источников — ни формулой, ни списком факторов. Всё, что есть в официальных документах, — общие формулировки и требования к допуску. Именно этот пробел конкуренты заполняют «факторами ранжирования в нейросетях», которых в природе не существует.
Что подтверждено документацией поисковых систем и вендоров
Начнём с того, что можно процитировать.
Google. В руководстве «AI features and your website» сказано прямо: «There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary» — никаких дополнительных требований и никакой особой оптимизации для попадания в ИИ-функции не нужно. Условие допуска одно: «a page must be indexed and eligible to be shown in Google Search with a snippet» — страница должна быть в индексе и иметь право на сниппет. Отдельно оговорено, что не нужны ни новые машиночитаемые файлы, ни специальная разметка: «There's also no special schema.org structured data that you need to add». Документ обновлён 10 декабря 2025 года.
Управление доступом там же: доступ роботов регулируется обычными директивами robots.txt для Googlebot, объём показываемого текста — тегами nosnippet, data-nosnippet, max-snippet и noindex, а обучение и grounding в других системах Google — отдельным агентом Google-Extended.
Яндекс. В блоге для вебмастеров описана механика Нейро: «Нейро берёт факты не из памяти генеративной модели, а из источников в интернете… Сервис всегда подкрепляет свой ответ ссылками на веб-страницы, откуда брал сведения». И там же — единственная официальная рекомендация владельцам: «Чтобы чаще появляться в источниках ответов Нейро, сайты должны высоко ранжироваться в Поиске и содержать контент, полезный для ответов на вопросы пользователей».
Обратная настройка тоже описана: директива User-Agent: YandexAdditional с Disallow: / убирает сайт из источников Нейро и быстрых ответов, применение занимает от 2 до 14 дней.
OpenAI и Perplexity документируют своих роботов — об этом отдельный раздел ниже.
Больше официальных источников по теме нет. Всё, что вы прочитаете про «веса», «сущностные графы» и «приоритеты платформ», — это гипотезы, а не документация.
Что показало исследование GEO, а что осталось гипотезой блогов
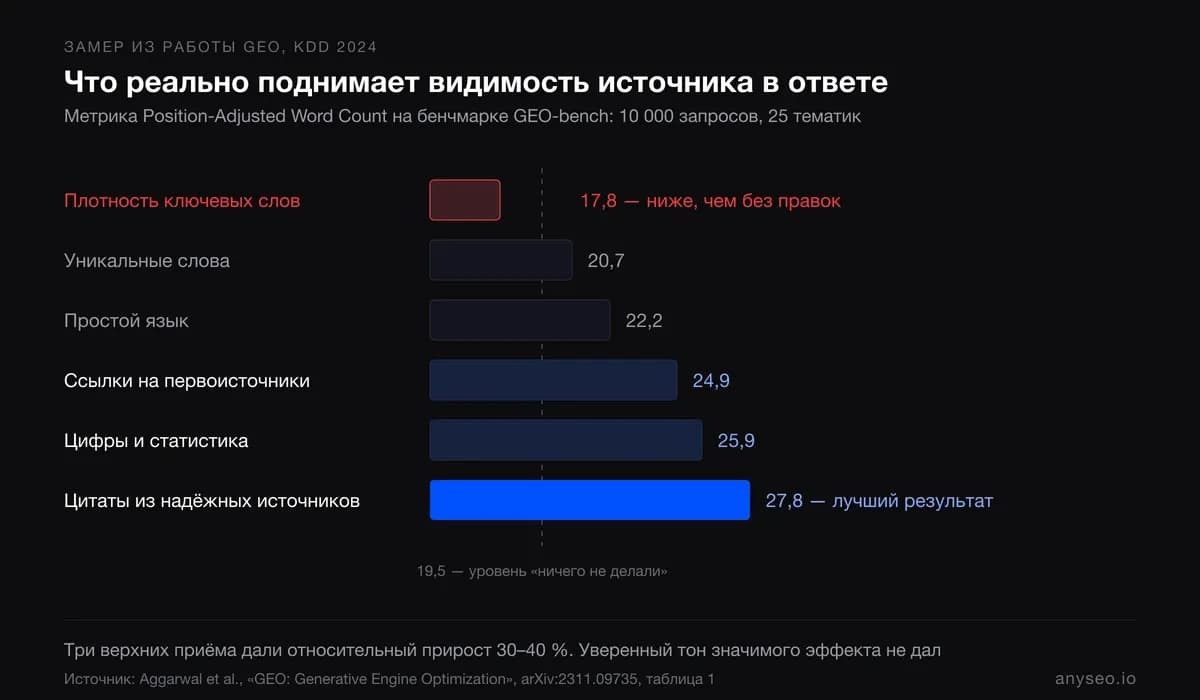
Единственный публичный замер эффекта — та самая работа Aggarwal et al. «GEO: Generative Engine Optimization» (arXiv:2311.09735, KDD 2024). Авторы собрали бенчмарк GEO-bench: 10 000 запросов из 25 тематических доменов с релевантными веб-источниками. Затем девятью приёмами переписывали текст источника и смотрели, как меняется его видимость в сгенерированном ответе.
Результаты по приёмам:
Последняя строка — главная. Классический приём «добавить вхождений ключа» в замерах опустил видимость источника ниже базовой линии: 17,8 против 19,5 без единой правки. Модель собирает ответ не по плотности ключа, а по тому, есть ли в тексте что процитировать.
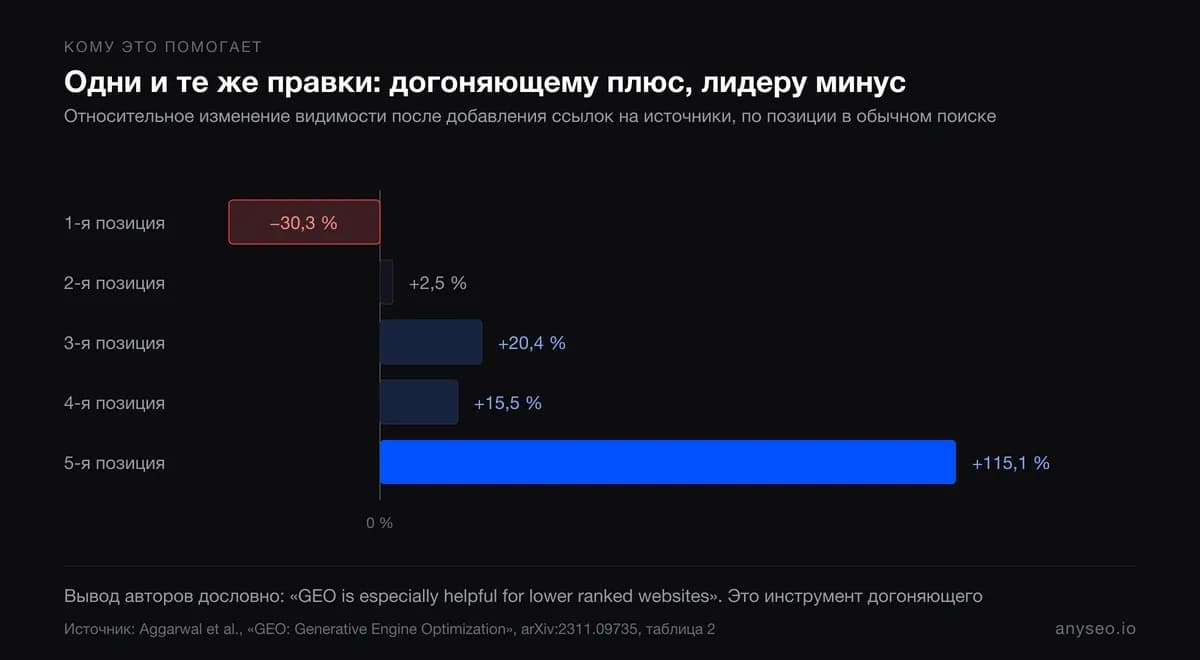
Второе неудобное наблюдение — из таблицы влияния позиции. Те же приёмы дают разный результат в зависимости от того, где источник стоял в обычном поиске: для источника с первой позиции добавление ссылок ухудшило видимость на 30,3 %, а для источника с пятой — улучшило на 115,1 %. Вывод авторов дословный: «GEO is especially helpful for lower ranked websites».
Ограничения работы называем честно: это лабораторный замер на бенчмарке, а не измерение выдачи Google или Яндекса; авторы сами показывают, что эффективность приёмов различается по тематикам. На реальном коммерческом движке прирост в их эксперименте составил до 37 %.
Техническая база: пустить ИИ-ботов на сайт
Всё, что ниже про контент, не работает, если робот не смог прочитать страницу. Техническая оптимизация тем и хороша, что конечна: её делают один раз и проверяют кодом, а не мнением.
Какие ИИ-боты ходят на сайт и как они называются
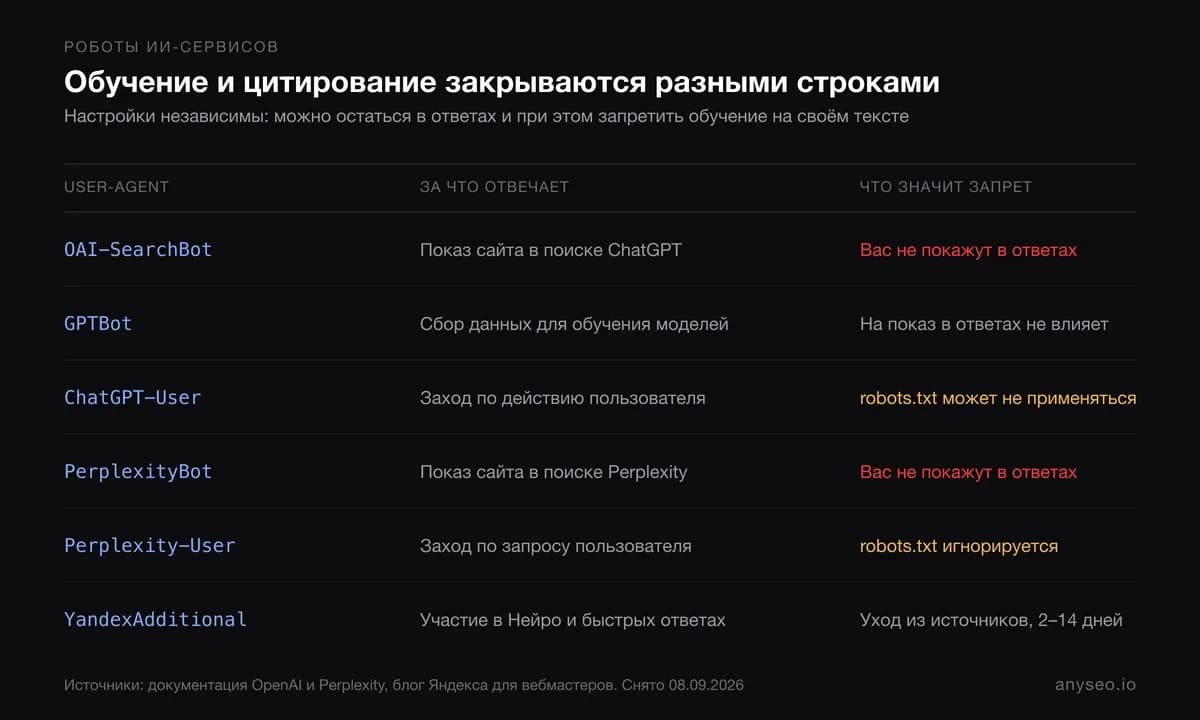
Роботов больше, чем принято думать, и у них разные задачи. По документации OpenAI:
- OAI-SearchBot отвечает за поиск внутри ChatGPT. Дословно: «used to surface websites in search results in ChatGPT's search features». Сайты, закрывшие этого робота, «will not be shown in ChatGPT search answers».
- GPTBot собирает данные, которые могут использоваться для обучения моделей. Запрет GPTBot означает отказ от обучения на вашем контенте, и только это.
- ChatGPT-User заходит по действию пользователя. Оговорка в документации важная: «Because these actions are initiated by a user, robots.txt rules may not apply».
- OAI-AdsBot проверяет посадочные страницы, поданные как реклама.
По документации Perplexity агентов два: PerplexityBot — обход для поиска, его рекомендуют разрешать; Perplexity-User — заход по запросу пользователя, и про него сказано так же прямо: «Since a user requested the fetch, this fetcher generally ignores robots.txt rules».
У Яндекса отдельный агент YandexAdditional отвечает не за доступ, а за отказ: он нужен, чтобы из источников ответов уйти. У Google отдельного «ИИ-робота» для поиска нет — доступ регулируется директивами для Googlebot, а Google-Extended управляет только обучением и grounding в других продуктах.
robots.txt: кого пускать, кого закрывать и чем это различается
Ключевая мысль, которую теряют почти все чек-листы: обучение и цитирование — это разные настройки, и закрывают их разные строки. OpenAI формулирует это буквально: «Each setting is independent of the others» — можно разрешить OAI-SearchBot, чтобы появляться в ответах, и одновременно запретить GPTBot, чтобы не отдавать контент в обучение.
Практическая рамка выглядит так:
- Хотите попадать в ответы ChatGPT — разрешите
OAI-SearchBot. - Не хотите, чтобы на вашем тексте учили модели, запретите
GPTBot. На показ в ответах это не влияет. - Для ответов Perplexity разрешите
PerplexityBot. - Чтобы уйти из источников Нейро, добавьте
YandexAdditionalсDisallow: /. Обратите внимание, что это отключит и быстрые ответы Яндекса тоже. - Не рассчитывайте, что robots.txt остановит заход по действию пользователя: и OpenAI, и Perplexity предупреждают, что для таких запросов правила могут не применяться.
Изменения не мгновенные: OpenAI указывает около суток на применение правок robots.txt, Perplexity — до 24 часов, Яндекс — от 2 до 14 дней.
JavaScript, скорость и стабильные URL
Дальше начинается обычная техническая гигиена, но с одной поправкой: ИИ-роботы менее терпимы к сложностям, чем поисковые.
Контент, который появляется только после исполнения скриптов, для части роботов не существует — они забирают HTML и уходят. Это ровно та ловушка, из-за которой при сборе корпуса конкурентов страница возвращается со статусом «успех» и десятком слов внутри. Если важный текст рисуется на клиенте, для ИИ-ответов его нет.
Адреса должны быть стабильными: страница, которую процитировали, обязана открываться по тому же URL завтра. Канонический адрес один, редиректы без цепочек, дубли сведены. И скорость ответа сервера: робот, который ждёт долго, просто уйдёт к следующему кандидату.
Нужен ли llms.txt
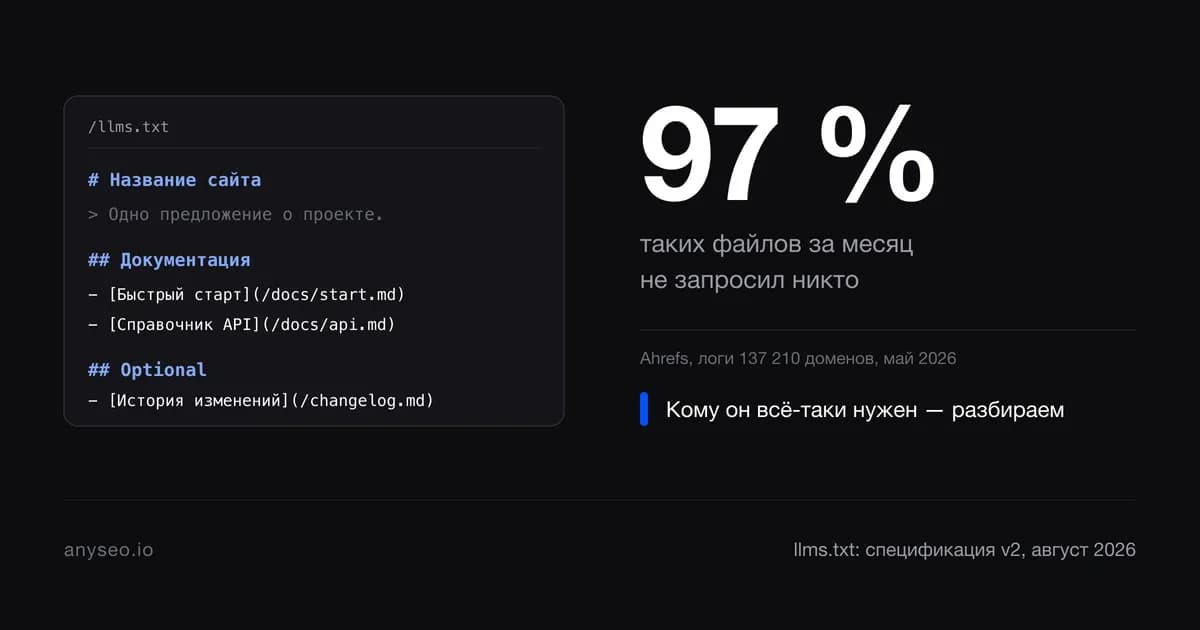
Коротко: файл llms.txt — это предложение формата, а не стандарт, поддержанный поисковыми системами. В документации Google по ИИ-функциям сказано, что для показа в них не нужны никакие новые машиночитаемые файлы. Мы разбирали формат llms.txt и его настоящих читателей отдельным материалом и выложили такой файл у себя — как эксперимент, а не как пропуск в ответы.
Решение по нему принимается спокойно: стоит копейки, вреда не приносит, гарантий не даёт. Если ради него откладывается доступность контента в HTML — приоритеты перепутаны.
Контент, который удобно процитировать
Здесь работает единственная часть GEO с измеренным эффектом. И она же самая простая: весь процесс оптимизации сводится к тому, как устроен отдельный абзац. Автор, который оптимизирует текст под цитирование, обязан проверять факты — иначе цитировать в нём нечего.
Прямой ответ в первых строках раздела
Модель собирает ответ из фрагментов. Фрагмент, который можно взять целиком, должен быть самодостаточным: понятным без предыдущего абзаца и без заголовка над ним.
Отсюда рабочее правило: раздел начинается с ответа, а не с подводки. «Директива YandexAdditional убирает сайт из источников Нейро за 2–14 дней» — годный фрагмент. «Многие владельцы сайтов задаются вопросом, как управлять участием в ответах нейросетей» — фрагмент, который невозможно процитировать: в нём нет утверждения.
Проверка занимает секунды: возьмите абзац, вырежьте его из статьи и прочитайте отдельно. Если он остался осмысленным — он пригоден для цитирования.
Цифры, цитаты и источники — приём с измеренным эффектом
Три приёма с подтверждённым приростом 30–40 % — это добавление статистики, добавление цитат из заслуживающих доверия источников и простановка ссылок на первоисточники. Ровно это, а не плотность ключевых слов.
Как это выглядит на практике:
- вместо «сайт должен быстро загружаться» ставим конкретный порог и то, чем он измерен;
- вместо «эксперты считают» пишем имя, компанию и место, где это сказано;
- вместо «по статистике» даём ссылку на документ, из которого взята цифра, с датой.
У этого приёма есть побочный эффект, который нам нравится: текст, из которого нельзя выбросить источники, невозможно написать быстро и без проверки фактов. Проверяемость и цитируемость здесь — одно и то же качество.
Структура: списки, таблицы и самодостаточные блоки
Замеры показали, что улучшение читаемости даёт 15–30 % прироста видимости. На практике это означает предсказуемые вещи: короткие абзацы, заголовки, сформулированные как вопрос или утверждение, таблицы для сопоставления вариантов, нумерованные шаги там, где есть настоящая последовательность.
Одно предостережение. Списки и таблицы улучшают текст только тогда, когда за ними стоит структура смысла. Разбив связное рассуждение на буллеты ради «ИИ-дружелюбия», вы теряете и связность, и содержание.
Разметка и сущности: Schema.org в задаче цитирования
Позиция Google по разметке в контексте ИИ-функций однозначна: специальной схемы для попадания в AI Overviews не существует, добавлять отдельную разметку под ИИ не нужно. Это дословно сказано в той же документации.
Значит ли это, что разметка бесполезна? Нет, она делает другую работу. Structured data помогает системе понять, что за страница перед ней, кто автор, когда обновлён материал, к какой организации он относится. Разметка, связывающая сущности (Organization, Person, sameAs), — это способ сообщить машине, кто вы, в форме, которую не надо угадывать из текста.
Практическая рамка простая: делайте Article, BreadcrumbList, Organization и Person потому, что они корректно описывают страницу и работают в обычном поиске. Не делайте их «ради нейросетей» и не ждите от них попадания в ответ.
Внешние площадки: почему нейросеть цитирует не ваш сайт
Регулярная история: в ответе на вопрос про вашу услугу модель ссылается на обзор в отраслевом издании, на форум и на справочник — но не на вас. Причина не в заговоре, а в том, что ответ собирается из нескольких источников, и ваш сайт конкурирует за место с площадками, у которых по этому вопросу больше материала.
Что здесь можно делать честно: публиковать материалы там, где ваша аудитория уже читает; следить, чтобы данные о компании в справочниках и на профильных площадках совпадали; отвечать на вопросы в профессиональных сообществах по существу.
Чего делать не стоит: покупать «упоминания для нейросетей» пачками и заказывать GEO-продвижение как отдельную услугу поверх неработающего сайта. Никакой документации, подтверждающей, что количество упоминаний влияет на цитируемость, не существует — это гипотеза, продаваемая как рабочая практика.
Как измерить GEO, а не поверить в него
Главная проблема этой темы — отсутствие привычной метрики. Позиции нет, а есть или нет вас в ответе — зависит ещё и от формулировки вопроса. Поэтому измерение строится не на одном числе, а на повторяемой процедуре.
Ручной замер промптов: метод, который можно повторить
Метод бесплатный и делается за час.
- Составьте список из 20–30 вопросов, которыми ваши клиенты описывают задачу. Не ключей — вопросов, как их задают вслух. Если семантическое ядро уже собрано, вопросы проще всего вырастить из него.
- Задайте их в тех сервисах, которые вам важны, и зафиксируйте: есть ли ваш домен в источниках, в каком месте ответа, что именно процитировано.
- Повторите то же самое через месяц, теми же формулировками.
- Считайте не «позицию», а долю вопросов, где вы попали в источники.
Важная оговорка: генерация вероятностна, и один и тот же вопрос даёт разные ответы. Поэтому единичный ответ ничего не доказывает — смысл имеет только доля по списку и её изменение во времени.
Трафик из нейросетей в Метрике и логах сервера
Второй контур — аналитика. Переходы из ИИ-сервисов приходят с домена сервиса, и в отчёте по источникам их видно как обычные реферальные. Оговорка: браузеры по умолчанию передают только домен, без текста запроса, а часть переходов из мобильных приложений и встроенных браузеров вообще не передаёт источник и попадает в «прямые заходы». Официальных документов вендоров о том, как именно они передают источник перехода, найти не удалось — поэтому такую аналитику считаем оценкой снизу, а не точным числом.
Отдельно про Google: показы и клики страниц, попавших в AI Overviews и AI Mode, не выделены в Search Console отдельной строкой — они входят в общий отчёт «Эффективность» по типу поиска «Веб». Это тоже честно написано в документации, и это значит, что «трафик из AI Overviews» из Search Console вы не достанете.
Третий контур — логи сервера. По user-agent видно, кто и как часто заходит: OAI-SearchBot, PerplexityBot, ChatGPT-User. Это единственный способ точно узнать, читают ли ваш сайт роботы ИИ-сервисов, и он не требует ничего, кроме доступа к логам.
Когда GEO не даст результата
Границы метода стоит проговорить до того, как под него выделен бюджет.
- Страница не в индексе или не ранжируется. И Google, и Яндекс формулируют требование одинаково: сначала обычная видимость. Пока её нет, генеративная часть неприменима.
- Вы уже первый источник по своей теме. Замеры показывают, что для источника с верхней позиции те же правки видимость снижали. Приёмы GEO — инструмент догоняющего, а не лидера.
- Спроса в ИИ-ответах нет. Если по вашей теме сервисы не показывают развёрнутый ответ со ссылками, оптимизировать нечего. Проверяется это за час ручным замером.
- Ожидание быстрого результата. Сколько занимает GEO-оптимизация даже в самой быстрой своей части: обход, переиндексация и применение директив — от суток до двух недель. Дальше начинается накопление, а не переключение тумблера.
Мы держимся здесь той же формулировки, что и в остальном: SEO — не мгновенный канал, и генеративный поиск его быстрее не сделал.
Что из этого мы сделали на своём сайте
Раздел, в котором положено показывать кейс. Кейса не будет — будет состояние на дату, потому что своих замеров цитируемости у нас пока нет. Блог anyseo.io мы ведём тем же конвейером, который собираем клиентам: спрос, семантика, факты с источниками, публикация с разметкой.
Что сделано и проверяется живым запросом (снято 8 сентября 2026 года): robots.txt открыт для всех роботов, кроме служебного раздела, — ни один ИИ-агент не заблокирован; файл llms.txt выложен и отдаёт 200; на страницах блога отдаётся JSON-LD Article, BreadcrumbList, Organization и Person; статьи связаны между собой внутренней перелинковкой, а не висят по отдельности.
Чего мы не делали: не выставляли адресных директив для OAI-SearchBot и PerplexityBot. При открытом User-agent: * они и так не заблокированы, но явные строки в robots.txt мы добавим. И главное: мы не измеряли свою цитируемость в ИИ-ответах и не станем утверждать, что она у нас есть. Домен молодой, статей в блоге на момент публикации три. Когда наберётся история, замер по методике из этой статьи мы опубликуем — с датой, списком вопросов и долей попаданий.
Это и есть проверка на честность любого материала про GEO: спросите у автора, какие цифры он измерил сам, каким инструментом и когда.
Источники
- Google Search Central — AI features and your website
- Блог Яндекса для вебмастеров — Яндекс запустил Нейро: как он работает
- OpenAI — Overview of OpenAI Crawlers
- Perplexity — PerplexityBot и Perplexity-User
- Aggarwal et al. — GEO: Generative Engine Optimization (KDD 2024)
- GEO-bench и полный текст работы, arXiv HTML
Об авторе
Автор anyseo — о SEO-стратегии, контенте и измеримом росте
Алексей Крайнов пишет для anyseo о практической стороне поискового продвижения: как исследовать реальный спрос, превращать его в понятную структуру сайта и оценивать вклад контента в задачи бизнеса. В материалах делает акцент на проверяемых источниках, ясных приоритетах и решениях, которые можно повторить на реальном проекте.
Все статьи автора