Sitemap.xml: как создать карту сайта и почему поисковик может её не заметить

Как устроен sitemap.xml, какие теги важны и как отправить карту в Яндекс.Вебмастер и Google Search Console, плюс типичные ошибки и разбор нашего собственного файла.
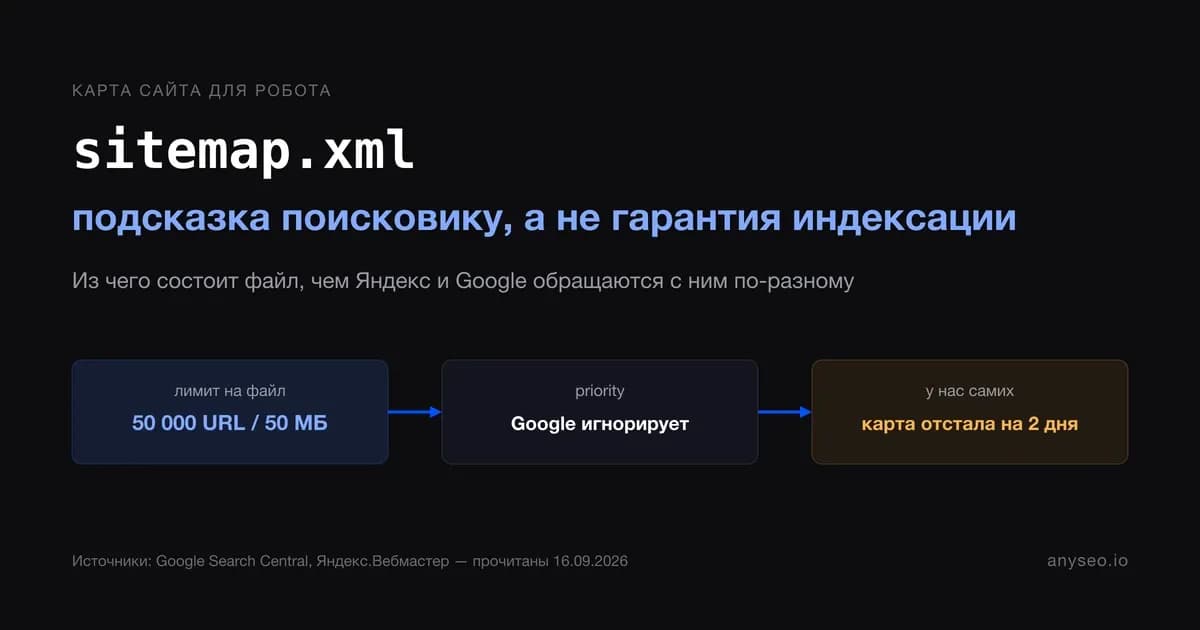
Sitemap.xml для одних сайтов — рабочий файл, который экономит время роботу. Для других — файл, который один раз сгенерировали плагином и больше не открывали. Разница не в размере сайта, а в том, попадают ли в него новые материалы автоматически или карта отстаёт от контента на недели.
«Карта сайта не гарантирует индексацию — это прямо написано в справке и Яндекса, и Google. Она помогает роботу быстрее найти страницы, но дальше решает не файл, а то, как сайт устроен технически», — говорит Алексей Крайнов, автор блога anyseo.
Разберём по порядку: когда sitemap.xml реально нужен, из чего состоит файл, чем поисковые системы обращаются с ним по-разному и что нашлось в нашем собственном sitemap.xml, когда мы проверяли его для этого материала.
Что такое sitemap.xml и когда он реально нужен
Sitemap — файл, который сообщает поисковым роботам о страницах вашего сайта и должен ускорить их индексацию. Это подсказка, а не команда: Яндекс.Вебмастер отдельно предупреждает, что не гарантирует попадание каждой указанной страницы в результаты поиска, и та же логика действует у Google.
Обе поисковые системы находят страницы прежде всего сами, переходя по внутренним и внешним переходам со страницы на страницу. Проблема в том, что робот иногда часть из них пропускает. Файл полезен, если у сайта:
- много страниц, и полный обход занимает у робота слишком долго;
- есть страницы без входящих навигационных ссылок — сиротские URL, которые не спасает даже аккуратная перелинковка страниц сайта;
- глубокая вложенность разделов, и до нижних уровней робот добирается за много шагов;
- контент подгружается через JavaScript, и часть переходов не видна в исходном HTML.
Небольшому сайту на десять—пятнадцать страниц с нормальной перелинковкой sitemap почти ничего не добавляет: робот и так обойдёт такой сайт за один-два визита. А блогу, который выпускает материалы каждую неделю, файл экономит время между публикацией и первым обходом нового материала. Карта нужна не всем, и вопрос «нужна карта сайта конкретному проекту или нет» стоит задавать раньше вопроса «как её сделать».
Из чего состоит файл: протокол, теги и ограничения
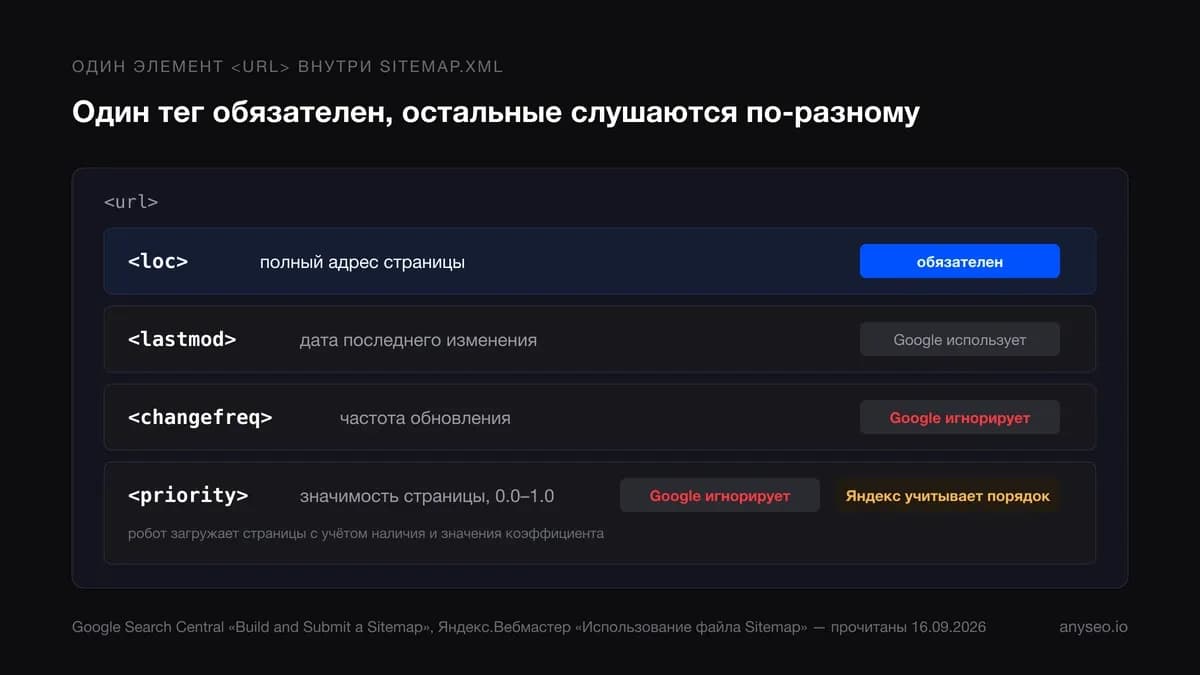
Sitemap.xml пишется по стандарту, который поддерживают обе поисковые системы. По-английски его называют sitemap xml или xml sitemap — оба варианта обозначают один и тот же файл. У корневого элемента urlset обязателен атрибут пространства имён по стандарту sitemaps.org. Внутри — произвольное число элементов <url>, и у каждого может быть до пяти дочерних тегов.
Единственный обязательный тег — <loc>. Остальные три — необязательное дополнение, и здесь у поисковых систем разные привычки.
Что означают lastmod, changefreq и priority — и почему поисковики их не всегда слушают
Google в документации формулирует это без обтекаемости: «Значения в тегах <priority> и <changefreq> игнорируются». Тег <lastmod> Google использует — но только если может проверить его точность, например сравнением с реальной датой изменения документа. Придуманная дата, которая не совпадает с фактом, доверия не добавляет.
У Яндекса позиция чуть другая. Справка Яндекс.Вебмастера прямо говорит, что робот «загружает страницы поочерёдно с учётом наличия и значения» коэффициента — то есть приоритет страницы всё-таки участвует в порядке обхода, а не отбрасывается сразу, как у Google. Отдельного заявления про частоту обновления в этой справке нет, и утверждать что-то конкретное про неё мы не будем — прямого подтверждения ни в одну сторону не нашли.
Практический вывод: дату изменения стоит проставлять всегда и по факту, без выдумывания. Тратить время на подбор идеального значения приоритета для каждого URL — почти всегда лишняя работа, разве что у сайта есть явная иерархия важности разделов, которую хочется подчеркнуть именно Яндексу.
Лимиты: 50 000 адресов и 50 МБ на один файл
Оба поисковика сходятся в одних цифрах. Один такой файл не может содержать больше 50 000 URL и не может весить больше 50 МБ в несжатом виде: так написано и в требованиях Яндекс.Вебмастера, и в документации Google. При превышении лимита сайт делят на несколько отдельных файлов и собирают их в общий список.
Дополнительно у Яндекса: кодировка только UTF-8, а каждая ссылка в файле должна вести на страницу того же домена, где сам файл размещён. Обычно его кладут в корень сайта, хотя стандарт разрешает и подкаталог, если карта описывает только его вложенное содержимое. Сервер при обращении к файлу должен отвечать кодом 200, иначе Яндекс сочтёт его недоступным.
XML-карта и HTML-карта сайта — не один и тот же инструмент
Формулировку «карта сайта» иногда путают. Прежде чем разбирать теги дальше, стоит закрыть вопрос, что такое карта сайта в двух её смыслах: служебный файл для роботов и обычная страница для людей — это не одно и то же. Читателю, который уже понял, что такое карта сайта в служебном смысле, объяснять человеческую версию отдельно не нужно — принцип тот же, разница только в получателе.
XML-версия не рассчитана на то, что её откроет человек. HTML-карта сайта — страница со ссылками на разделы, оформленная для навигации живых посетителей: с понятными названиями, иногда с иерархией по категориям.
Одно не заменяет другое. HTML-карта помогает пользователю быстро найти раздел и добавляет внутренние переходы, которые полезны читателю, — но робот всё равно предпочитает формализованный файл, потому что тот дешевле разбирать и в нём нет декоративной вёрстки. Сайту со сложной иерархией разделов имеет смысл держать обе версии — служебную для роботов и человеческую для посетителей, и путать их в разговоре с подрядчиком не стоит: правки в одной не заменяют вторую.
Sitemap Index: когда одного файла не хватает
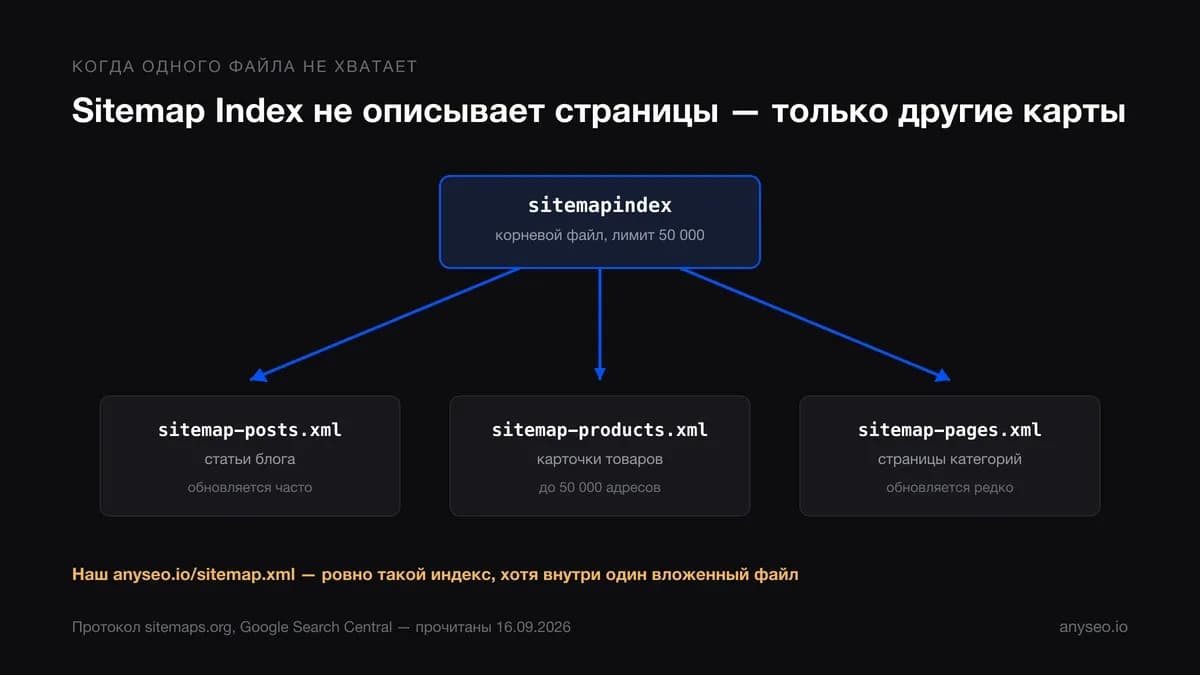
У большого интернет-магазина на сотни тысяч товаров или каталога объявлений один файл быстро упирается в лимит 50 000 адресов. Решением становится файл индекса sitemap: он не содержит сами URL страниц, а перечисляет пути к другим файлам. Такой индексный файл иногда называют картой карт, потому что он не описывает страницы напрямую, только другие карты.
Корневой элемент у файла индекса sitemap не urlset, а sitemapindex, и внутри не <url>, а элементы <sitemap> с адресом каждого вложенного документа. Индекса sitemap может быть один на весь проект, а вложенных карт может быть сколько угодно: отдельно для статей блога, отдельно для карточек товаров, отдельно для страниц категорий. Если вложенных документов много, у самого списка имеет смысл проставить дату обновления тем же тегом <lastmod>, но уже на уровне списка, а не отдельной страницы.
Наш собственный anyseo.io/sitemap.xml — ровно такой файл индекса sitemap, хотя внутри всего один вложенный документ, sitemap-0.xml: генератор, который его собирает, создаёт индексный файл сразу, даже когда весь сайт укладывается в одну карту. К этому файлу мы вернёмся ниже — там нашлась не самая приятная деталь.
Как создать sitemap.xml: три рабочих способа
Способ выбирают не по вкусу, а по тому, как часто на сайте появляются новые страницы.
Плагин или модуль CMS
Для сайта на готовой системе управления сайтом — WordPress, Битрикс, Tilda и аналоги — самый живучий вариант. Плагины создают карту сайта автоматически при каждой публикации: она не отстаёт от контента, потому что пересборка встроена в тот же процесс, что и сохранение статьи.
Долгое время стандартом для WordPress был плагин Google XML Sitemaps, но сейчас эту функцию давно закрыли Yoast SEO, RankMath и аналогичные SEO-модули, у которых создание карты сайта идёт в комплекте с остальной технической оптимизацией. У крупных систем управления сайтом карта нередко входит в комплект по умолчанию, без отдельной установки.
Онлайн-генератор
Такие инструменты — их часто называют sitemap generator — обходят сайт по ссылкам и предлагают создать файл sitemap по готовому списку URL. Подходит для статичного сайта без CMS или для разовой проверки: собрать xml-карту с помощью онлайн-генератора, посмотреть, что получилось, поправить руками при необходимости.
Слабое место у любого sitemap generator одно: он не знает о будущих страницах. Опубликовали новую статью — xml-карту он сам не обновит, придётся запускать обход повторно.
Вручную или программно
Создать файл sitemap руками имеет смысл только для маленького статичного сайта на десяток страниц: скопировать структуру, экранировать спецсимволы в xml-файлах, проставить <loc> для каждой страницы, проверить синтаксис. Для сайта с нестандартным движком, где нет ни плагина, ни готового генератора, карту собирают программно — скриптом, который читает список URL из базы и на его основе создаёт документ по шаблону.
Риск у обоих вариантов один: человеческая ошибка в теге, относительная ссылка вместо абсолютной или пропущенная кодировка — такой файл поисковая система просто не разберёт.
Как отправить sitemap.xml в Яндекс.Вебмастер и Google Search Console
Файл, который лежит на сервере вашего сайта, сам по себе поисковым системам не виден. Сообщить о нём можно двумя равноправными способами — свежая инструкция Яндекса подтверждает это словом «или»: указать путь к файлу в директиве Sitemap в robots.txt или добавить его в панели вебмастера.
В Яндекс.Вебмастере это раздел «Индексирование → Файлы Sitemap»: вписываете полную ссылку на файл и нажимаете «Добавить». В Google Search Console — раздел Sitemaps: туда же вставляете путь и жмёте «Отправить». Обе панели после этого показывают статус обработки и статистику — сколько страниц найдено, есть ли ошибки.
Указывать sitemap в robots.txt дополнительно, даже если карта уже добавлена в панели, не строго обязательно — ни у одной из систем эта директива не помечена как обязательная (у Яндекса звёздочкой отмечен только User-agent). Но у строки в robots.txt есть практическая польза: её видит любой робот, который обходит сайт, а не только тот, что привязан к вашему аккаунту, — включая роботов других поисковиков и сервисов, понимающих тот же стандарт.
После отправки файл не появляется в поиске мгновенно: Яндекс предупреждает, что на обработку изменений может уйти до двух недель, а при использовании индекса с несколькими вложенными картами — и того больше.
Hreflang и специальные карты: изображения, видео, новости
Многоязычным сайтам он пригождается ещё для одной задачи: разметки языковых версий. Вместо тега <link rel="alternate" hreflang="..."> в коде каждой страницы можно один раз собрать все связи в файле: у каждого <url> внутри <loc> стоит конкретный адрес, а рядом стоит набор <xhtml:link rel="alternate" hreflang="...">, перечисляющих все языковые версии этой страницы, включая её саму. Такая ссылка на себя обязательна: без неё Google может не принять всю группу.
Хорошая новость для больших многоязычных проектов: дочерние записи hreflang не считаются в лимите 50 000 URL — они не занимают отдельные позиции, а просто прикрепляются к существующим.
Отдельно существуют расширения для изображений, видео и новостей — они добавляют собственное пространство имён и теги внутри тех же записей <url>, а не заменяют обычную карту. Это необязательный инструмент: рядовому сайту без объёмной фото- или видеогалереи он не нужен, обычная карта справляется без надстроек. Похожий принцип — у llms.txt: только тот файл адресован не поисковым роботам, а языковым моделям.
Типичные ошибки в sitemap.xml — и что нашлось у нас самих
Прежде чем давать абстрактный список ошибок, честно проверим собственный файл — это тот самый повод для доверия, о котором мы писали в начале.
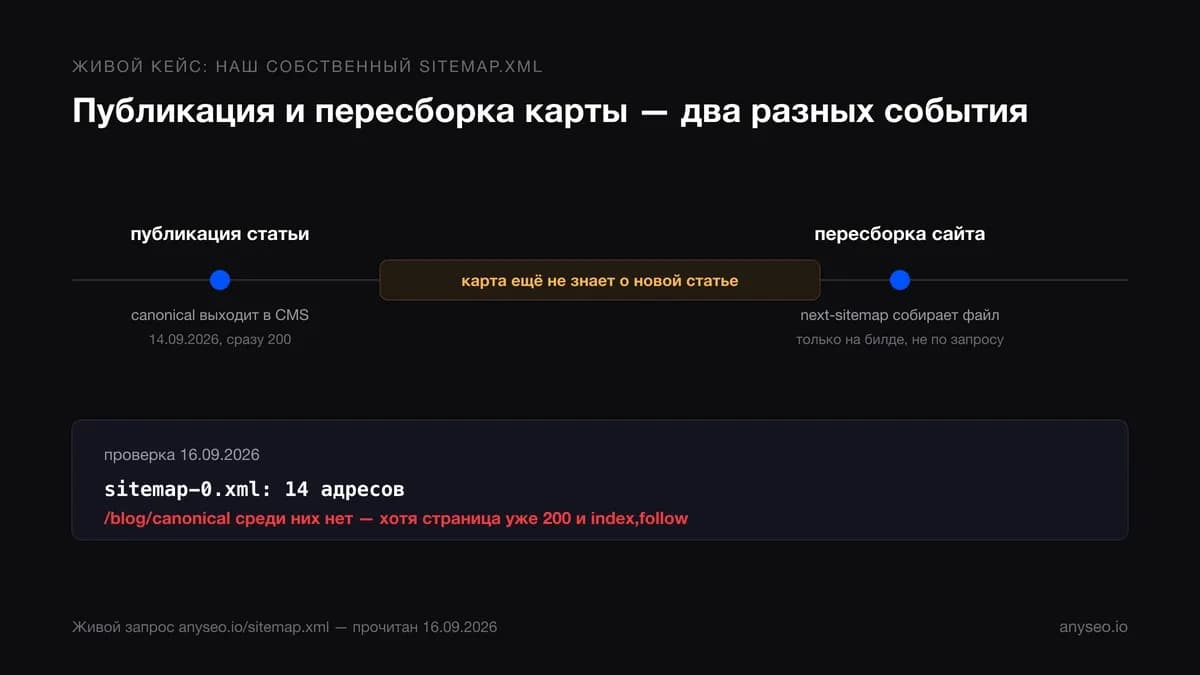
Проверка anyseo.io/sitemap.xml в день подготовки этого материала показала: в файле 14 URL, и статьи о canonical среди них нет, хотя она опубликована двумя днями ранее и живая страница отдаёт 200 и index, follow. Причина не в Strapi и не в самой статье: генератор, который собирает файл, делает это на этапе билда сайта, а не по запросу. Публикация в CMS и пересборка фронтенда — два разных события, и между ними карта честно отстаёт. Мы уже фиксировали это как открытую задачу в собственном бэклоге раньше: сейчас та же причина проявилась на новой статье.
Отсюда и общий список того, что чаще всего ломается в чужих файлах:
- Карта собирается на билде, а не на запросе. Наш собственный случай самый показательный: между публикацией страницы и следующей пересборкой сайта карта не знает о новом URL. Для проектов с частыми публикациями это значит регулярную задержку, а не разовую случайность.
- В карте остаются закрытые в robots.txt страницы. Если при обращении к конкретному URL сервер отдаёт код, отличный от 200, или robots.txt запрещает обход, Яндекс отмечает файл как «не проиндексирован», что заметно в статистике панели.
- Относительные ссылки вместо абсолютных. Протокол Sitemap требует абсолютный URL с полным доменом в каждом
<loc>: короткий путь без него карта не примет. - Устаревшие страницы после переезда или удаления. Обновлять карту сайта вручную после каждой правки структуры неудобно, а если адреса меняются из-за переезда, одного 301 редиректа недостаточно: карту тоже нужно поправить. Файл, который не трогали месяцами, тянет за собой мёртвые адреса — это не критическая ошибка, но и не польза: робот тратит часть внимания на проверку того, чего давно нет.
- Неподдерживаемые элементы в структуре. Яндекс в такой ситуации не отбрасывает документ целиком: неизвестные теги игнорируются, а данные из поддерживаемых обрабатываются как обычно, специально чинить файл ради этой ошибки не нужно.
Sitemap.xml — не сложный файл, но он живёт на стыке двух процессов: публикации контента и сборки сайта. Стоит потерять этот стык из виду, и карта начинает отставать незаметно для всех, кроме робота, который честно читает её раз в несколько дней.
Источники
- Google Search Central: Build and Submit a Sitemap
- Яндекс.Вебмастер: Использование файла Sitemap
- Яндекс.Вебмастер: Как запретить или разрешить обход (robots.txt)
- Google Search Central: Как создать и отправить файл robots.txt
- Google Search Central: Локализованные версии страниц (hreflang в sitemap)
- Google Search Central: Combine sitemap extensions (image/video/news)
- Протокол Sitemaps — sitemaps.org
Об авторе
Автор anyseo — о SEO-стратегии, контенте и измеримом росте
Алексей Крайнов пишет для anyseo о практической стороне поискового продвижения: как исследовать реальный спрос, превращать его в понятную структуру сайта и оценивать вклад контента в задачи бизнеса. В материалах делает акцент на проверяемых источниках, ясных приоритетах и решениях, которые можно повторить на реальном проекте.
Все статьи автора