robots.txt: как настроить файл и почему Disallow не убирает страницу из поиска

Разбор robots.txt по справкам Яндекса и Google: синтаксис директив, приоритет правил при конфликте, границы действия файла, коды ответа и ошибки, которые стоят индексации.
Файл robots.txt лежит в корне почти любого сайта, и почти на любом сайте в нём есть строка, которая не работает. Иногда безвредно, вроде нашего собственного случая, к которому мы вернёмся в конце. Иногда дорого: владелец закрывает раздел от индексации, а раздел продолжает висеть в выдаче.
Разберём файл по частям: что он на самом деле умеет, чем набор директив Яндекса отличается от набора Google, каким образом обе системы разбирают конфликт правил и что проверить у себя за десять минут. Все факты ниже сверены прямым чтением справок Google и Яндекса, блогов обеих команд и текста стандарта — ссылки стоят по месту.
Что такое файл robots.txt и что он делает
Robots.txt — текстовый файл в корне сайта, который указывает роботу, какие адреса ему разрешено обходить. Это не настройка сервера и не часть кода: обычный текст, который скачивается первым, ещё до запроса самой страницы.
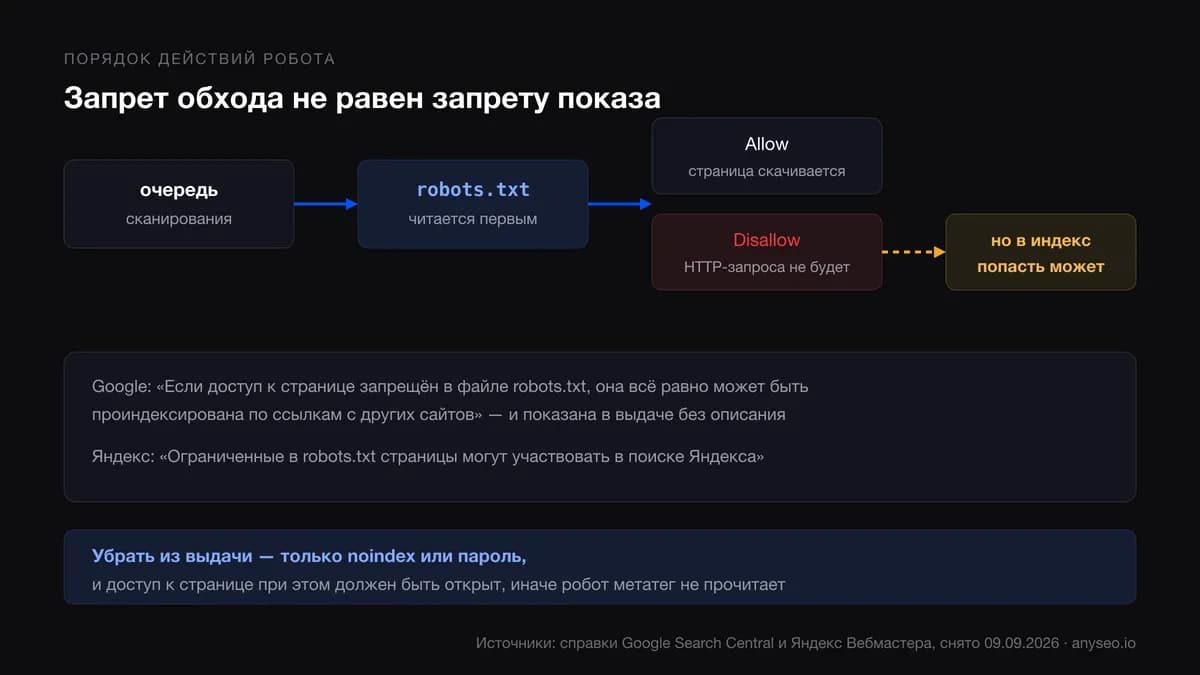
Механика простая. Googlebot получает URL из очереди сканирования и сначала читает robots.txt. Если доступ к адресу запрещён, Googlebot не отправляет HTTP-запрос вообще — просто пропускает его. У Яндекса та же последовательность.
Отсюда первое следствие, которое стоит запомнить: файл управляет обходом, а не показом. Он отвечает на вопрос, каких роботов и куда пускать, а не на вопрос, что показывать в выдаче. Поисковые роботы читают его первым и дальше действуют по написанному: файл экономит краулинговый бюджет и снимает нагрузку с сервера. Ровно это и написано в справке Яндекса: ограничение индексирования в файле «может снизить нагрузку на сайт и ускорить его работу».
Формально это не изобретение Яндекса и Google, а стандарт исключений для роботов — Robots Exclusion Protocol. Он описан в RFC 9309, опубликован IETF в сентябре 2022 года по категории Standards Track. До этого протокол двадцать семь лет держался на договорённости по традиции.
Главное недоразумение: Disallow не убирает страницу из выдачи
Это самая дорогая ошибка в теме, и обе системы говорят о ней прямым текстом.
Google: «Файл robots.txt не предназначен для того, чтобы запрещать показ ваших материалов в результатах поиска Google». И там же сказано, что произойдёт вместо этого: если на закрытую страницу ведут ссылки с других сайтов, Googlebot может добавить её в индекс, даже не открывая. Такие адреса показываются в выдаче без описания: роботы могут узнать о странице, ни разу её не открыв. Ссылки при этом не обязательно чужие: робот доходит до закрытой страницы и по внутренней перелинковке вашего же сайта.
Яндекс формулирует не мягче: «Ограниченные в robots.txt страницы могут участвовать в поиске Яндекса».
Дальше идёт ловушка, в которую попадают чаще всего. Владелец видит страницу в выдаче, ставит на неё noindex и оставляет Disallow в файле. На страницу он не приходит, метатег не читает, страница остаётся в выдаче. Яндекс предупреждает об этом прямым примечанием: «Не ограничивайте такие страницы в robots.txt, чтобы робот Яндекса смог их проиндексировать и обнаружить ваши указания».
Что делать вместо этого
- Нужно убрать страницу из выдачи: метатег
<meta name="robots" content="noindex">или HTTP-заголовокX-Robots-Tag, и доступ к странице в файле открыт. - Нужно не пустить робота на служебный раздел, тяжёлый фильтр, бесконечную пагинацию: директива
Disallow. - Нужно и то и другое: сначала
noindexи ждём переобхода, только потом закрываем адрес в robots.txt.
Ещё одно: noindex внутри самого файла не работает у Google с 1 сентября 2019 года. Команда Search Central объявила об этом 2 июля 2019-го: «we're retiring all code that handles unsupported and unpublished rules (such as noindex)». Строка остаётся в файле, но её никто не читает.
Директивы: полный разбор синтаксиса
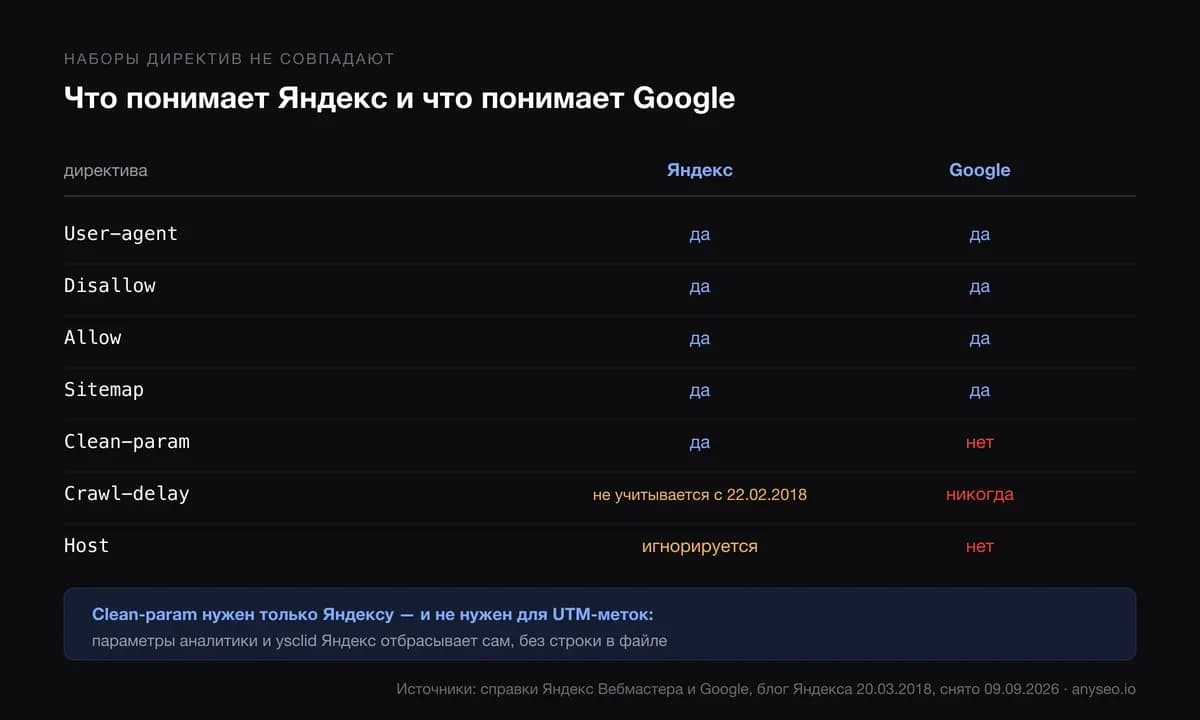
Наборы директив у двух систем разные, и это первое, что теряется в чек-листах «правильный robots.txt».
Google перечисляет поддерживаемые поля списком и добавляет в скобках: «другие поля, например `crawl-delay`, не поддерживаются». Яндекс приводит свою таблицу из пяти директив в справке Вебмастера.
User-agent — кому адресовано правило
Обязательная директива: с неё начинается любой блок. Значение * адресует правила всем роботам сразу, Yandex относит их к роботам Яндекса, Googlebot — к основному роботу Google.
Важная деталь: если есть блок для конкретного агента, общий блок он не читает вообще. Яндекс описывает это буквально: при наличии строки User-agent: Yandex строка User-agent: * не учитывается, а при наличии директив для агента вроде YandexBot не используются оба общих блока. У Google логика та же: робот выбирает одну группу, где агент указан наиболее конкретно, остальные игнорирует.
Практический вывод: нельзя дописать User-agent: Yandex с одной строчкой и рассчитывать, что остальные правила из * продолжат действовать. Не продолжат.
Disallow и Allow — что закрываем и что открываем обратно
Disallow: /admin/ запрещает обход раздела. Allow: /catalog/auto открывает вложенный адрес внутри закрытого раздела. Пустой Disallow: не запрещает ничего, Disallow: / закрывает весь сайт.
Путь указывается от корня, начинается со слэша, регистр учитывается: /Catalog и /catalog — разные адреса. При этом в названиях самих директив регистр роли не играет.
Приоритет правил: кто побеждает при конфликте
Здесь механика у обеих систем одинаковая, и она контринтуитивная.
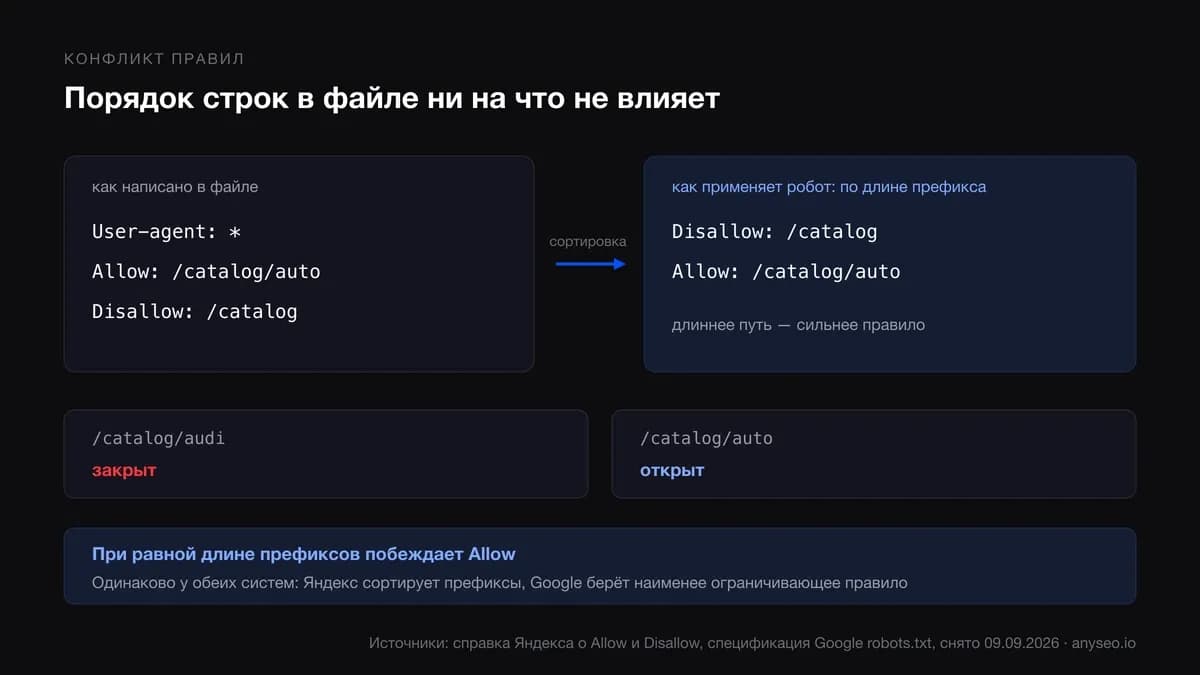
Яндекс: директивы `Allow` и `Disallow` сортируются по длине префикса URL от меньшего к большему и применяются последовательно, выбирается последняя подходящая из отсортированного списка. При равной длине префиксов приоритет у Allow.
Google описывает то же самое другими словами: применяется правило с более длинным значением пути, а при конфликте побеждает то, которое предполагает наименьшие ограничения.
Из этого следует вывод, который почти никогда не пишут прямо: порядок строк в файле не имеет значения. Обе системы сортируют правила сами. Спор «Allow выше или ниже Disallow» — спор ни о чём.
User-agent: *
Disallow: /catalog
Allow: /catalog/auto
Здесь /catalog/audi закрыт, /catalog/auto открыт, и порядок двух последних строк на результат не влияет.
Sitemap — где лежит карта сайта
Sitemap: https://example.com/sitemap.xml — полный адрес с протоколом. Директива не привязана к блоку User-agent и может стоять в любом месте файла. Это самый дешёвый способ показать карту, если вы не подтверждали сайт в панелях вебмастера.
Clean-param — директива, которой нет у Google
Clean-param указывает роботу Яндекса, что параметр в адресе не меняет содержимое страницы, и такие адреса не нужно считать разными страницами. Синтаксис — Clean-param: p0[&p1&p2&..&pn] [path], ограничение 500 символов на правило.
Яндекс рекомендует её вместо Disallow для страниц с параметрами: так основной адрес получает накопленные показатели, а при закрытии через Disallow они теряются. Причина, по которой дубли вообще опасны, лежит уровнем выше robots.txt: две страницы отвечают на один запрос и делят между собой один результат. Разбор этой механики у нас в материале о том, как собрать семантическое ядро.
И сразу поправка к самому частому совету в чужих статьях. Прописывать в Clean-param UTM-метки не нужно: справка Яндекса перечисляет utm_source, utm_medium, utm_campaign, ysclid, yrclid и остальные метки аналитики среди параметров, которые отбрасываются автоматически, и добавляет: «Для таких параметров не требуется дополнительных действий в robots.txt».
Crawl-delay и Host — то, что уже не работает
Crawl-delay задавала паузу между запросами. Яндекс перестал её учитывать 22 февраля 2018 года , скорость обхода теперь настраивается в Вебмастере. Google эту директиву не поддерживал никогда.
Host указывала главное зеркало сайта. Яндекс от неё отказался; в блоге для вебмастеров 20 марта 2018 года команда Яндекса ответила на вопрос о судьбе директивы так: «её можно удалить из robots.txt или оставить, робот её просто игнорирует». Главное зеркало задаётся постраничным 301-редиректом.
Спецсимволы: звёздочка и знак доллара
Два символа, которые превращают список путей в правила.
*— любая последовательность символов.Disallow: /*?закрывает все адреса с параметром.$— конец адреса.Disallow: /page$закроет/page, но не тронет/page/subpage.
Тонкость, которая ловит новичков: правило без $ работает префиксом. Disallow: /cat закрывает и /catalog, и /category, и /caterpillar — всё, что начинается с этих букв.
Где должен лежать файл и на что он распространяется
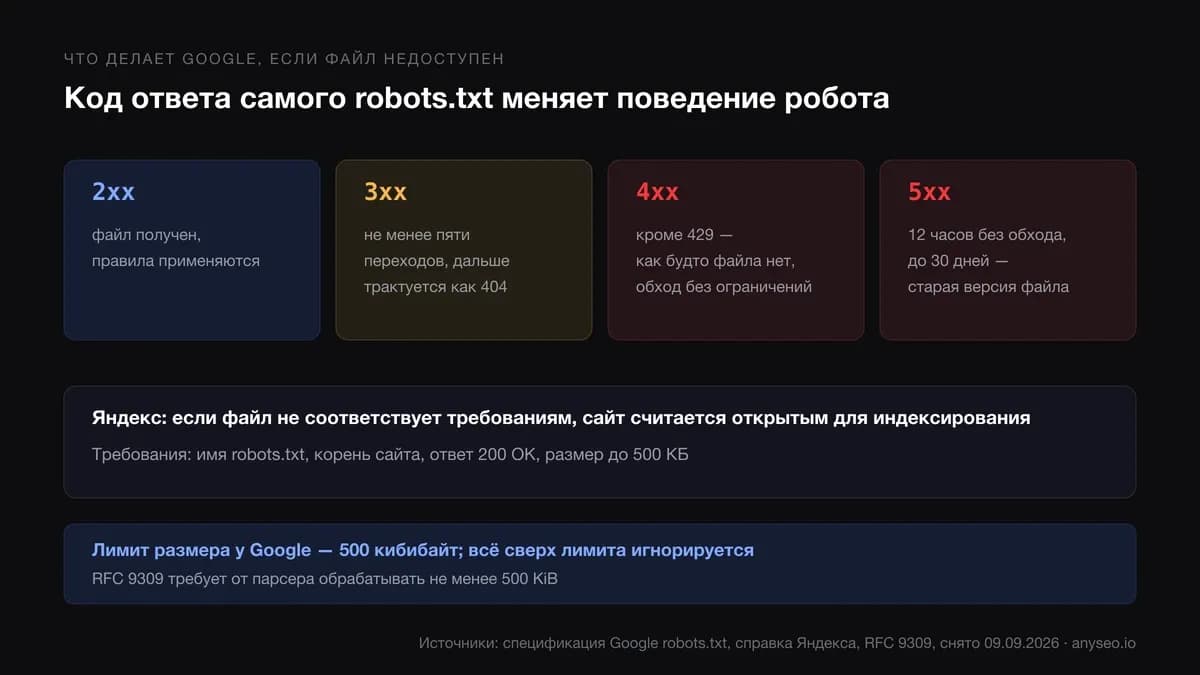
Требования Яндекса конкретны: TXT-файл с именем robots.txt, размещён в корневом каталоге, сервер отвечает кодом 200 OK, размер не больше 500 КБ. Google называет свой лимит точнее — 500 кибибайт, и предупреждает, что содержимое сверх лимита игнорируется. RFC 9309 требует от парсера обрабатывать не менее 500 KiB.
Границы действия описаны в спецификации Google: правила действительны только для того хоста, протокола и порта, по которым доступен сам файл. Из этого следуют три вещи, которые регулярно ломают сайты:
https://example.com/robots.txtне действует наhttps://blog.example.com/: у поддомена свой файл.- Он же не действует на
http://example.com/— другой протокол. - Нестандартный порт означает снова отдельный файл.
Ещё одно требование, специфичное для рунета: кириллица в robots.txt запрещена. Домены записываются в Punycode, адреса страниц — в процентной кодировке. Disallow: /корзина роботом Яндекса не поймётся, нужен Disallow: /%D0%BA%D0%BE%D1%80%D0%B7%D0%B8%D0%BD%D0%B0.
Создать файл robots.txt: порядок работы
- Создайте в текстовом редакторе файл в кодировке UTF-8. Блокнот,
nano, что угодно — форматирования быть не должно. Имя строго одно:robots.txt, строчными буквами. Ни robots txt с пробелом, ни robots-txt через дефис, ниRobots.TXTне опознаются. - Опишите блоки:
User-agent, затемDisallowиAllowдля него. - Добавьте
Sitemapс полным адресом карты. - Положите файл в корень, чтобы он открывался по
https://ваш-домен/robots.txtи отдавал 200. - Проверьте результат инструментами обеих панелей — разберём их ниже.
Создать файл robots.txt по этой схеме можно за один заход. Порядок Яндекса тот же и заканчивается той же оговоркой: сначала проверить в Вебмастере, потом класть в корень. Создание файла занимает пять минут, а вот проверка — то место, где обычно и находится ошибка.
Примеры robots.txt под популярные CMS
Готовый шаблон не заменяет проверку: набор служебных адресов, например страниц фильтра, зависит от версии движка, плагинов и настройки фильтров. Рабочая логика везде одна — закрыть админку, внутренний поиск, корзину и сравнение, оставить открытым всё, что участвует в отрисовке страницы.
WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/
Sitemap: https://example.com/sitemap.xml
admin-ajax.php открывают обратно намеренно: через него работает часть фронтенда, и закрытый файл ломает отрисовку.
1С-Битрикс
User-agent: *
Disallow: /bitrix/
Disallow: /personal/
Disallow: /search/
Disallow: /*?
Allow: /bitrix/js/
Allow: /bitrix/templates/
Sitemap: https://example.com/sitemap.xml
Здесь важны две строки Allow: скрипты и шаблоны нужны для рендеринга, а Disallow: /bitrix/ закрывает их вместе со всем разделом.
Проверка файла: Яндекс Вебмастер и Search Console
В Яндекс Вебмастере это Инструменты → [Анализ robots.txt](https://yandex.ru/support/webmaster/ru/indexing-options/robots-txt-analyzer). Инструмент показывает содержимое и результаты разбора, хранит историю версий и, что полезнее всего, в блоке «Доступ к страницам» позволяет подставить конкретные адреса и увидеть, обойдёт их робот или нет.
У Google в Search Console есть отчёт о файлах robots.txt. Он показывает, какие файлы найдены в двадцати доменах сайта, когда сканировались в последний раз, какие были предупреждения и ошибки, и позволяет запросить повторное сканирование. Оговорка из справки: отчёт доступен только для ресурсов уровня домена или префиксных ресурсов без пути — для https://example.com/path/ его не будет.
Ни один сторонний онлайн-сервис не отвечает на главный вопрос: что об этом файле думает конкретный робот. Панели отвечают.
Ошибки, которые дороже остальных
Закрыли CSS и JS. Googlebot читает robots.txt до запроса ресурса, и заблокированный файл он не скачивает. Прямая формулировка справки: «Google Поиск не обрабатывает код JavaScript на страницах и в файлах, которые заблокированы». Робот видит сломанную страницу и оценивает то, что увидел.
Файл отдаёт не 200. Google трактует любую ошибку 4xx, кроме 429, за отсутствие файла и сканирует сайт без ограничений. При 5xx он не сканирует сайт первые 12 часов, а потом до 30 дней использует последнюю удачную версию. Яндекс формулирует ещё жёстче: «Если файл не соответствует требованиям, сайт считается открытым для индексирования».
Редирект в никуда. Google проходит не менее пяти переходов в цепочке, дальше считает ситуацию ошибкой 404. Яндекс редирект поддерживает и учитывает файл, на который перенаправили, — но только если тот отдаёт 200.
Файл в роли списка секретов. Об этом прямо предупреждает RFC 9309 в разделе Security Considerations: перечисление путей делает их публично обнаружимыми. Строка Disallow: /admin-backup-2019/ — не защита, а указатель. Закрывать доступ нужно паролем или кодом ответа, а не просьбой не заходить.
Правило под несуществующий синтаксис. Crawl-delay, Host, noindex внутри файла, кириллица — всё это не ошибки в смысле «файл сломается». Машина просто пройдёт мимо строки, а вы будете считать задачу решённой.
ИИ-боты: отдельная задача, а не строчка в файле
Поисковые роботы ИИ-сервисов читают тот же файл, но правила у них другие: доступ для обучения и доступ для цитирования в ответе — разные настройки и разные агенты. Запретить GPTBot значит отказаться от обучения на своём контенте, но не убрать себя из ответов. И у OpenAI, и у Perplexity в документации прямо оговорено, что при заходе по действию пользователя правила robots.txt могут не применяться.
Рядом с robots.txt в этой задаче появился и второй файл: llms.txt, и мы разбирали, кто его на самом деле читает. Тема большая, мы разобрали её отдельно — со списком агентов, сроками применения правок и способом замерить результат: GEO-оптимизация: как попасть в ответы нейросетей.
Что лежит в robots.txt у нас
Мы проверили собственный файл, пока писали статью. GET https://anyseo.io/robots.txt → 200, снято 9 сентября 2026 года:
User-agent: *
Allow: /
Disallow: /dashboard/

# Host
Host: https://anyseo.io

# Sitemaps
Sitemap: https://anyseo.io/sitemap.xml
Здесь есть ровно та строка, о которой мы писали выше: Host. Директива, которую Яндекс игнорирует с марта 2018 года. Её сгенерировал по умолчанию next-sitemap при сборке сайта, вреда от неё нет, её просто пропускают. Но это мёртвый код в файле, который читают все роботы, и мы его уберём.
Заодно видно, что представляет собой честный минимальный файл: открыт весь сайт, закрыт личный кабинет, указана карта. Больше на молодом сайте закрывать нечего, и придумывать нечего тоже.
Частые вопросы
Что будет, если robots.txt на сайте нет?
Сайт считается открытым для обхода целиком. Для маленького сайта без служебных разделов это рабочий вариант. Для магазина с фильтрами — нет: правильно настроенный файл robots.txt здесь помогает роботам не утонуть в комбинациях параметров.
Нужен ли отдельный robots.txt для поддомена?
Да. Файл действует только на свой хост, правила основного домена на поддомен не распространяются.
Можно ли закрыть весь сайт от индексации?
User-agent: * и Disallow: / остановят обход, но не гарантируют исчезновение из выдачи: адреса, на которые ведут внешние ссылки, могут остаться в индексе. Надёжный способ — пароль.
Влияет ли robots.txt на скорость сайта?
Косвенно. Запрет обхода служебных разделов снижает нагрузку от обхода — Яндекс называет это одной из причин использовать файл. На скорость для живого посетителя он не влияет никак.
Часто ли нужно проверять файл?
После каждого релиза, который меняет структуру адресов, и после смены CMS или движка сборки. Наш пример с Host ровно про это: строку добавил сборщик, а не человек.
Источники
- Google Search Central: общие сведения о файлах robots.txt
- Google Search Central: как Google интерпретирует спецификацию robots.txt
- Блог Google Search Central: A note on unsupported rules in robots.txt (02.07.2019)
- Google Search Central: основы SEO для сайтов на JavaScript
- Справка Search Console: отчёт о файлах robots.txt
- Яндекс Вебмастер: использование файла robots.txt
- Яндекс Вебмастер: директивы Disallow и Allow
- Яндекс Вебмастер: директива User-agent
- Яндекс Вебмастер: директива Clean-param
- Яндекс Вебмастер: директива Crawl-delay
- Яндекс Вебмастер: анализ robots.txt
- Блог Яндекса для вебмастеров: 301-й редирект полностью заменил директиву Host (20.03.2018)
- RFC 9309: Robots Exclusion Protocol (IETF, сентябрь 2022)
Об авторе
Автор anyseo — о SEO-стратегии, контенте и измеримом росте
Алексей Крайнов пишет для anyseo о практической стороне поискового продвижения: как исследовать реальный спрос, превращать его в понятную структуру сайта и оценивать вклад контента в задачи бизнеса. В материалах делает акцент на проверяемых источниках, ясных приоритетах и решениях, которые можно повторить на реальном проекте.
Все статьи автора